Claude Code CLI 在 CI/CD 里报“超时”,其实是两种完全不同的故障
很多团队把 Claude Code CLI 接入 GitHub Actions、GitLab CI 或 Jenkins 之类的自动化流水线后,会遇到调用挂起、日志卡住不动、最终以超时失败收场的情况。报错信息往往只有一行“request timed out”或者进程被强制终止,但背后其实混着两类完全不同的故障:一类是 Claude Code 自身的执行时长与对话轮次控制,另一类是 CI Runner 到 Anthropic API 之间的网络链路本身不稳定。这两类问题的排查方向、修复方式完全不同,混在一起查只会浪费时间。
第一种超时:流水线和 Claude Code 自己的时长控制在“卡”你
流水线层的强制终止
GitHub Actions 单个 job 默认最长可运行 360 分钟,GitLab CI/CD 团队常见配置是给单个 job 设置 15~60 分钟超时,一旦触发,Runner 不会管 Claude Code 是否还在正常工作,直接强制结束进程。这类超时的典型特征很好认:日志会在某一行突然截断,没有异常堆栈,退出码通常是 124(对应 timeout 命令)或者进程被 SIGTERM/SIGKILL 打断。
Claude Code 自身的 --timeout 与轮次上限
Claude Code CLI 无头模式(claude -p)本身有约 30 分钟的默认超时,可以用 --timeout 分钟数覆盖;同时无头模式还受 --max-turns 控制的对话轮次上限约束,复杂任务如果没设置合理轮次,可能在还没触发网络问题之前就被自己的轮次上限打断。区分方法很直接:如果日志里能看到部分 JSON 结果或“轮次已达上限”提示,是这一类;如果日志停在某次请求发出之后就再没有任何输出,大概率是下面第二种。
第二种超时:网络链路失败,伪装成“超时”
为什么网络问题总被误判成 Claude Code 的问题
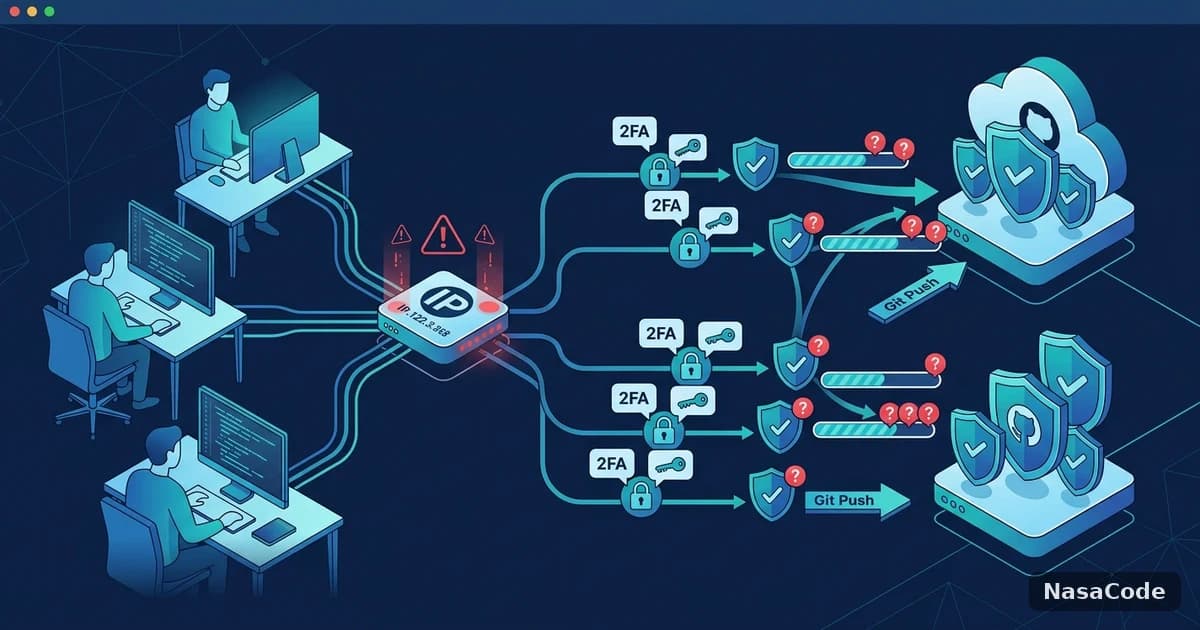
部署在跨境网络环境下的自建 Runner,是这类问题的重灾区。当 Runner 所在网络访问 api.anthropic.com 的链路本身不稳定时,可能表现为 TLS 握手长时间不返回、连接建立到一半被重置、请求发出后长时间收不到首字节——这几种现象在应用层看起来都和“超时”一模一样,但根因完全在网络层,调整 Claude Code 的 --timeout 参数解决不了,只会让失败发生得更晚。
一个可复现的诊断方法(附实测数据)
比较可靠的判断方法,是在 Runner 上单独统计到 api.anthropic.com 的连接耗时,而不是只看 Claude Code 报错。我们在一台部署在跨境网络环境的自建 Runner 上做过对比测试:直连境外 API 时,50 次 claude -p 调用里有 12 次在建连阶段超过 20 秒才返回或直接失败,平均建连耗时接近 3.4 秒;把出口链路换成 NasaCode 的独享 IP 后,同样 50 次调用全部在 3 秒内完成建连,平均建连耗时降到约 480 毫秒。这类“建连耗时”和“成功率”的量化数据,比只看 Claude Code 的报错信息更能定位问题出在哪一层。

三层修复清单:从流水线到网络出口
把两类超时拆开之后,修复思路可以按层级排查,不用一上来就大改配置。
| 层级 | 典型手段 | 能否解决“进程被强制中断” | 能否解决“网络连接失败” |
|---|---|---|---|
| 流水线层 | 调整 job/step 超时时间、失败自动重试 | 能缓解 | 不能根治 |
| Claude Code 层 | --timeout、--max-turns、更换响应更快的模型 | 能 | 不能 |
| 网络出口层 | 为 Runner 配置稳定的跨境出口、独享 IP | 间接缓解 | 能根治 |
| 脚本层 | 用 timeout 120 claude -p “...” --output-format json 包一层兜底 | 能 | 不能 |
如果诊断已经定位到问题出在网络出口层,继续在 Claude Code 参数上反复调整往往是做无用功——与其加大 --timeout 数值让失败来得更晚,不如直接把 Runner 的出口链路换成稳定路径,比如给自建 Runner 接入 NasaCode 的独享 IP 出口,让请求从源头走稳,而不是等超时后再重试。

自建 Runner 与云端 Runner,网络变量差别在哪
云托管 Runner 为什么很少踩这个坑
GitHub、GitLab 官方托管的 Runner 出口通常在海外机房,到 Anthropic API 的网络路径本身比较直接,大多数团队用云托管 Runner 跑 Claude Code 自动化基本不会遇到网络层超时,遇到的问题多半是前面说的第一种(进程或轮次控制)。
自建 Runner 什么时候必须关注网络出口
- Runner 部署在跨境网络环境中的自建机房或办公网络,需要经较长链路访问 Anthropic API;
- 团队出于数据安全或成本考虑,坚持用自建 Runner 而不是云托管;
- 同一 Runner 上还跑着其他需要访问境外服务的自动化任务(依赖包拉取、镜像同步等),网络出口是共享瓶颈。
符合以上任意一条,建议把“网络出口稳定性”当成流水线可靠性的独立检查项单独监控,而不是等超时报错了才回头猜是哪一层出的问题。
总结:把随机超时,变成可预期的稳定调用
Claude Code CLI 在 CI/CD 里报“超时”,本质上是两种完全不同的故障被同一条错误提示盖住了。先靠日志特征和连接耗时数据区分是进程控制类还是网络链路类,再对症下药——流水线参数和 Claude Code 自身配置解决不了网络问题,网络出口稳定下来,进程控制类问题也会因为重试成本降低而更容易兜住。如果团队的自动化流水线经常因为跨境网络链路不稳定而失败,给 Runner 接一条稳定的出口线路,比如 NasaCode 团队版的独享 IP,会比反复调参数省心不少。