Git LFS 大文件推拉失败,问题往往出在单个对象的传输上
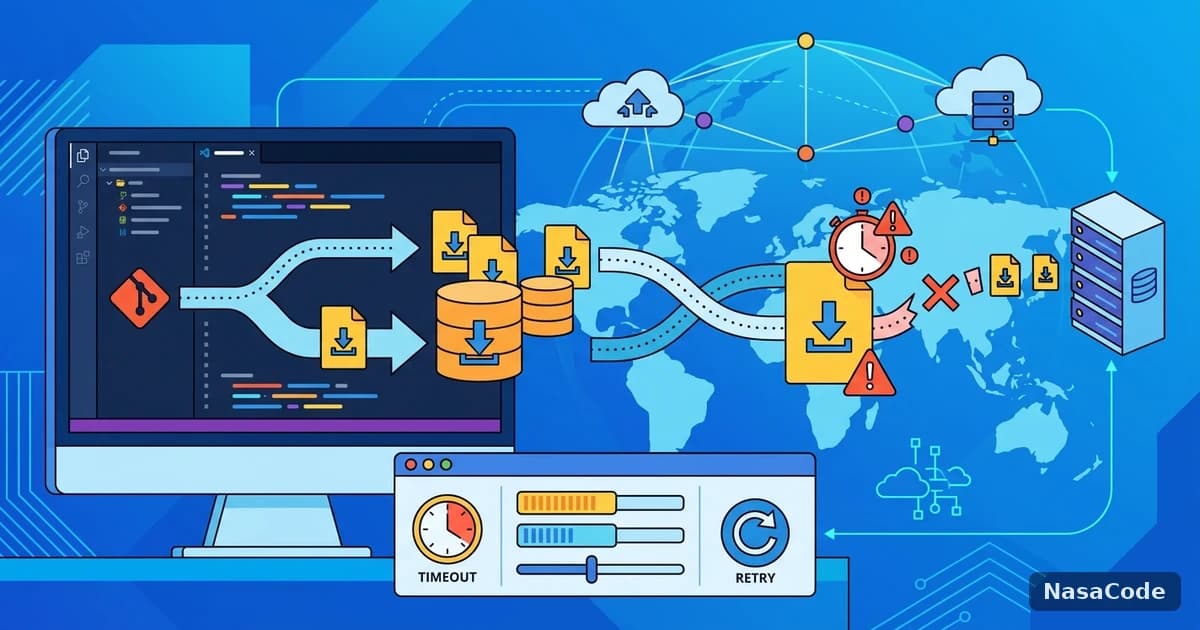
Git LFS 把大文件换成仓库里一个很小的文本指针,真正的文件内容存在远端服务器上。这意味着你执行 git push 或 git clone 的时候,实际上发生了两件事:普通 Git 传输指针和提交,LFS 再另外按对象源源不断地上传或下载文件内容。跨境链路上出问题时,往往是其中某一个体积很大的对象在传输途中被中断,而不是整个 Git 仓库访问不通。本文对照 Git LFS 官方配置文档,说明超时、并发、重试这几类参数怎么调,再给出一套逐步定位的方法。和普通 Git 仓库拉取慢相关的内容,可以再看Git clone 和 Docker pull 跨境慢的分析。参数名与默认值来自 2026 年 10 月查阅的官方文档,版本不同可能有差异。

先搞清楚:LFS 流量走哪条路
很多人用 SSH 地址访问仓库,就以为 LFS 也走 SSH。实际上 LFS 的文件传输使用 HTTPS,和仓库本身的传输方式是两条独立的通道,分流规则、代理和白名单都要分别考虑。可以用下面的命令查看 LFS 当前使用的服务地址与配置:
git lfs env
git lfs ls-files
GIT_TRACE=1 GIT_TRANSFER_TRACE=1 GIT_CURL_VERBOSE=1 git lfs push origin main
git lfs env 会列出当前生效的端点和存储路径,第三条带跟踪变量的命令能看到每个对象请求的地址和报错。尤其要留意,实际上传或下载的地址可能与仓库域名不同,防火墙放行和分流规则要把日志里出现的这些地址一并考虑。
三类参数:超时、并发、重试
lfs.activitytimeout 为什么是大文件超时的首选调整项
官方配置文档显示,lfs.activitytimeout 默认值是 30 秒,表示等待 TCP 读写的时间。上传大对象时,服务端可能需要一段时间整理数据才会回应,跨境链路延迟高时这 30 秒就容易不够用,表现为 i/o timeout。可以先试适度调大:
git config lfs.activitytimeout 120数字只是起点。拿到新的现象后再判断:如果超时消失了,说明原来就是等待不够;如果只是把失败变得更慢,那就不是超时参数的问题,要回到链路。同一组里还有 lfs.dialtimeout(建立连接等待,默认 30 秒)和 lfs.tlstimeout(TLS 握手等待,默认 30 秒),分别对应连接和握手阶段的报错。
并发数调高还是调低
lfs.concurrenttransfers 默认值是 8,表示同时传输的对象数。带宽充足、文件小而多时可以保持默认;但链路不稳、文件体积大时,多个大文件同时传输会互相抢占带宽,单个对象的进度反而变慢。这时把并发降到 2 或 3,让每个对象更快完成,往往比全部同时传更稳。
重试参数怎么理解
lfs.transfer.maxretries 默认 8,表示每个对象失败后的重试次数;lfs.transfer.maxretrydelay 默认 10 秒,表示重试之间的最长等待。这说明单个对象的短暂失败会自动重试,不需要手工追加。如果你看到的是重试用完后才报错,说明链路不是偶发抖动,而是持续性的不稳定。
| 参数 | 默认值 | 适合调整的现象 |
|---|---|---|
| lfs.activitytimeout | 30 秒 | 上传大对象时 i/o timeout |
| lfs.dialtimeout | 30 秒 | 建立连接阶段就失败 |
| lfs.tlstimeout | 30 秒 | TLS 握手阶段报错 |
| lfs.concurrenttransfers | 8 | 多个大文件同时传输全部变慢 |
| lfs.transfer.maxretries | 8 | 偶发中断后的重试预算 |
拉取大文件:按需拉取和分次拉取
克隆含有大量 LFS 文件的仓库时,把「拉代码」和「拉大文件」拆开,是跨境链路下最有效的做法。文档中的环境变量 GIT_LFS_SKIP_SMUDGE 设为真时,检出文件不会把指针自动转换为真实对象,这样先快速得到代码,再按需下载需要的大文件。
- 先用
GIT_LFS_SKIP_SMUDGE=1 git clone 仓库地址完成代码克隆,此时大文件仍是指针。 - 用
git lfs ls-files看有哪些对象、各自大小和路径。 - 用
git lfs pull --include="models/"这类写法只拉需要的目录,其余的后面再说。也可以用lfs.fetchexclude排除不需要的路径。 - 拉取中断后直接重新执行同一条命令,已经完整下载过的对象会被跳过,只继续剩下的部分。
上面两个路径和仓库地址都是示例,请换成你自己的。如果你的仓库托管在 GitHub,且普通 Git 的 SSH 22 端口也在超时,可以再参考改走 443 端口的配置与判断方法,把 Git 传输和 LFS 传输两条链路分开检查。
一套分步定位的方法
如果调了参数仍然失败,建议按下面的思路逐步判断:先把引起失败的对象找出来,再判断是大小相关还是时段相关。如果只有体积超过某个阈值的对象失败,多半是单个请求的持续时间超过了中间设备或服务端的限制,就要核对服务端的单文件大小和请求超时设置;如果任何大小都在某个时段失败,则更像线路问题。
线路稳定性差的环境里,大文件推拉是最先暴露问题的场景。NasaCode 提供的全局代理和分流能力,可以让 git、LFS 对象存储的域名单独走一条更稳定的出口;是否有明显改善,建议用同一批文件在前后各测几次,记录传输耗时和重试次数。
小结
Git LFS 的大文件传输是按对象走 HTTPS 的独立通道,调参先看 lfs.activitytimeout,并发量大时适当降低 lfs.concurrenttransfers,拉取时用 GIT_LFS_SKIP_SMUDGE 验证代码与大文件分开拉。所有参数的默认值以你使用版本的官方文档为准。