Hugging Face 模型下载中断,先判断要不要「全部下」
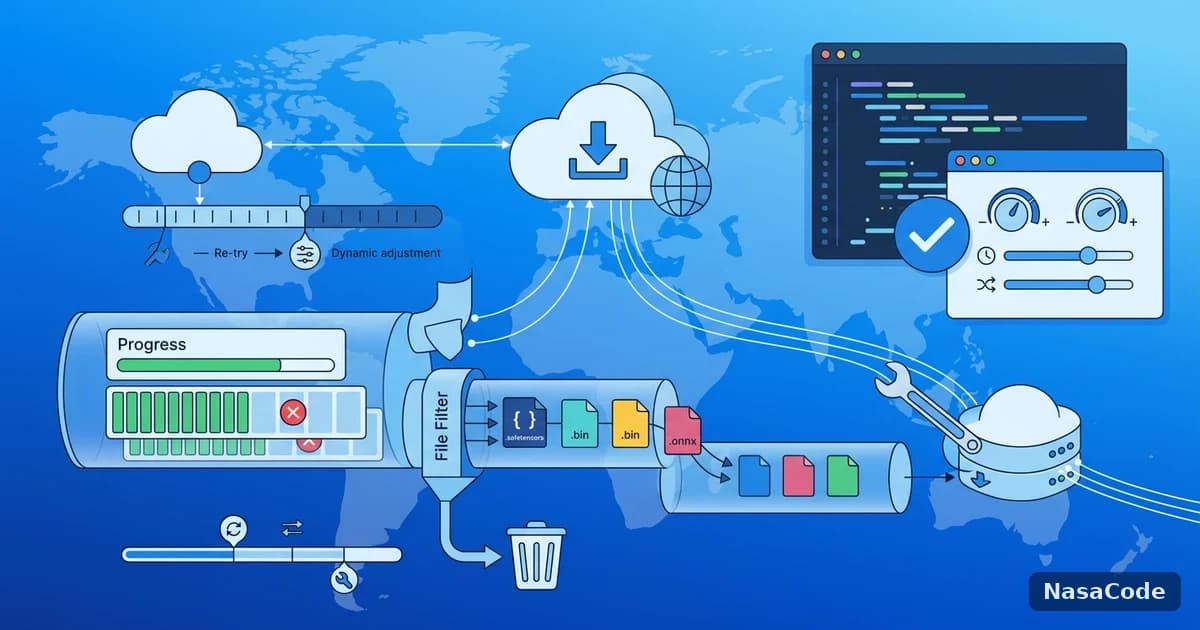
开发者从 Hugging Face 下载模型时,一个仓库里往往同时放着多种格式的权重(比如 safetensors、旧的 bin、ONNX 等),把整个仓库拉下来体积可能大几倍。跨境链路上下载这么大的数据,中途断开几乎不可避免。所以比起反复重试,更有效的思路是三步:先只下真正需要的文件,再用超时变量和并发模式适配你的网络,最后再考虑镜像。本文对照 huggingface_hub 官方文档和环境变量说明,查阅时间为 2026 年 10 月,命令、环境变量和默认值在后续版本可能调整,请先在你的环境里确认。

第一步:用 dry-run 和过滤,先把下载量压下来
怎么在下载之前知道要下多大
官方的 hf download 命令支持 --dry-run,它会列出仓库里的文件、哪些已经在本地缓存、以及预计需要下载的体积。文档里的示例显示,一个仓库可能同时包含多个格式的权重文件,全部拉下来要几 GB。先跑一次预估,再决定要不要过滤。
hf download 仓库用户名/模型名 --dry-run
hf download 仓库用户名/模型名 --include "*.safetensors" --include "*.json"
上面的仓库名是占位符。如果你在 Python 里使用 snapshot_download,对应的参数是 allow_patterns 和 ignore_patterns,支持通配符,可以组合使用,比如只拿 safetensors 权重和配置文件,跳过其它格式。
local_dir 和缓存目录怎么选
默认情况下文件会进入官方缓存目录,默认位置为 ~/.cache/huggingface,可以用 HF_HOME 调整。若指定 local_dir,文件会按原始结构保存到那个目录,并在目录下创建 .cache/huggingface/ 存放元数据,用来避免重复下载已是最新的文件。文档提醒,这个元数据目录删掉以后重跑脚本会花更长的恢复时间,所以下载未完成前不要手工清理。
第二步:超时、并发与续传的实际表现
HF_HUB_DOWNLOAD_TIMEOUT 与 HF_HUB_ETAG_TIMEOUT 区别在哪里
官方环境变量文档里,HF_HUB_ETAG_TIMEOUT 控制下载前获取最新元数据的等待时间,默认 10 秒,超时后会退回使用本地已有缓存;HF_HUB_DOWNLOAD_TIMEOUT 控制下载文件时等待服务器响应的时间,默认也是 10 秒,超时会抛出 TimeoutError。文档明确写到:网络慢的机器适合把下载超时调高,而完全断网时较小的值能让失败更快暴露。
export HF_HUB_DOWNLOAD_TIMEOUT=60
export HF_HUB_ETAG_TIMEOUT=30
这两个数字只是调试起点。注意官方说明,环境变量是在导入 huggingface_hub 时读取的,在脚本里导入之后再修改不会生效,必须在导入之前设置。
高性能模式为什么在不稳定链路上要谨慎
现在 Hugging Face 已经由 Xet 存储后端支撑,下载通过 hf_xet 完成,官方说明它基于分块去重,并且安装较新版本的 huggingface_hub 会自动带上它。HF_XET_HIGH_PERFORMANCE 会让工具尽可能占满网络带宽和全部 CPU 核心做并行传输。带宽充足、延迟稳定的环境里这很有效,但在丢包较多的跨境链路上,占满带宽可能让连接更容易中断,建议先关闭,确认稳定后再尝试开启并对比。若使用机械硬盘,还可以参考文档里关于顺序写盘的变量。
| 环境变量 | 官方说明的作用 | 建议使用场景 |
|---|---|---|
| HF_HUB_DOWNLOAD_TIMEOUT | 下载时等待服务器响应,默认 10 秒 | 链路慢、偶发超时 |
| HF_HUB_ETAG_TIMEOUT | 获取元数据的等待,默认 10 秒 | 已有缓存但元数据请求超时 |
| HF_HUB_OFFLINE | 不再发起任何 HTTP 请求,只用缓存 | 文件已经全部在本地,只想加载 |
| HF_XET_HIGH_PERFORMANCE | 占满带宽和 CPU 做并行传输 | 链路稳定、带宽大 |
关于续传,官方缓存机制会把已完整下载的文件记录下来,重新执行同一条命令时已完成的文件会被跳过,只继续剩下的;单个文件内部能否从断点接着下,不同版本的表现略有差异,请以你手里的版本实际行为为准,建议在一个小模型上先验证一次。
第三步:镜像与代理,选之前先想清楚三件事
很多人一遇到下载慢就想到换到镜像站。huggingface_hub 支持通过终端环境变量把请求指向另一个端点(变量名为 HF_ENDPOINT,具体用法和限制请核对你所用版本的文档),但选择之前建议先想清楚三点:
- 镜像的运营方是谁、是否可信。模型文件会被加载进你的运行环境,来源不明的镜像存在文件被替换的风险。
- 镜像同步是否及时、是否完整。刚发布的模型或需要鉴权的私有仓库,镜像通常拿不到。
- 公司内部自建的代理或缓存服务是更稳妙的选择,团队里所有人共用同一份缓存,只需要跨境拉取一次。
下载完成之后建议核对文件大小和哈希或者官方公布的校验信息。终端里代理变量和超时变量的写法和常见误区,可以参考代理与超时环境变量怎么写;同类的依赖下载超时思路,可以看pip、cargo、go mod、Maven 的镜像与超时参数配置。
链路本身不稳时,把下载机的出口固定下来
调完过滤、超时和并发之后,如果下载仍然在对应时段反复断开,就值得检查出口线路。可以用 curl -w "%{time_connect} %{time_appconnect}\n" -o /dev/null -sS https://huggingface.co 分时段记录连接耗时,再把下载过程中的断点和这些耗时对照。NasaCode 针对开发机提供稳定出口和分流规则,适合把模型下载这类长时间、大流量的任务单独走一条线路;是否有明显改善,请用同一个模型在前后各测几次,比较中断次数和总耗时。
小结
下载大模型的稳定做法是:先用 --dry-run 和过滤把体积压下来,用 HF_HUB_DOWNLOAD_TIMEOUT 适配链路,谨慎使用高性能模式,选择镜像前先评估可信度和完整性。具体默认值以你使用的 huggingface_hub 版本官方文档为准。