现象:编辑到一半突然提示“连接已断开”
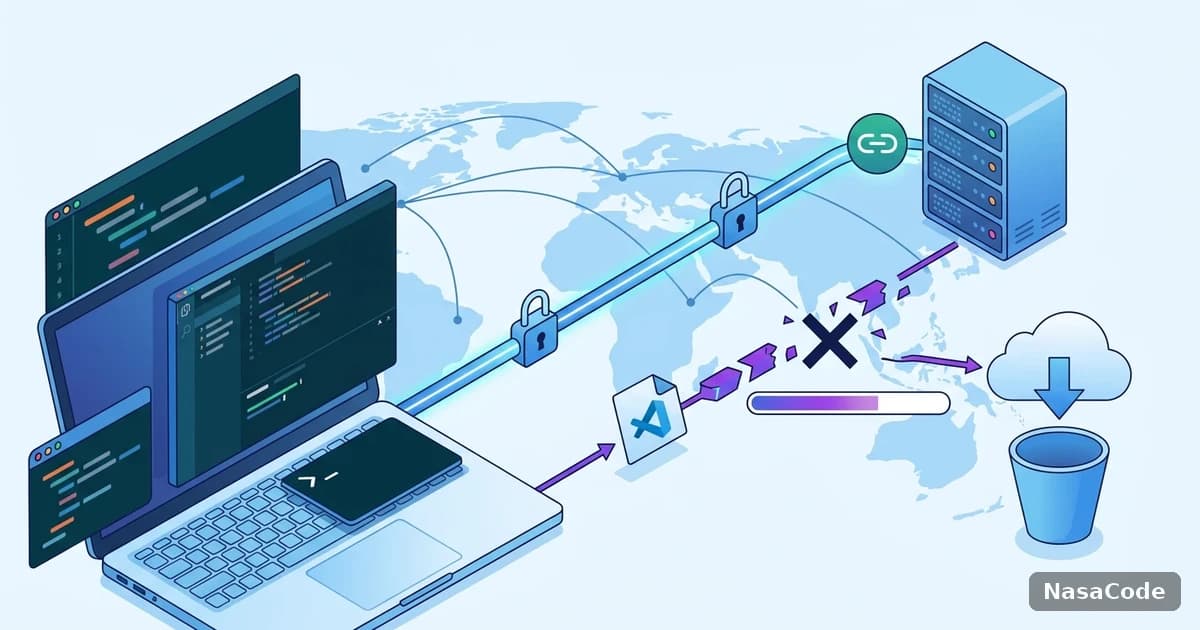
使用 VSCode Remote-SSH 或 Dev Containers 连接远程开发机是跨境开发团队的常见工作方式,但不少开发者都遇到过编辑到一半突然提示“Connection lost”、终端进程被杀、未保存代码丢失的情况。这类问题往往不是单一原因,需要先分清楚断开发生在哪一层,才能对症下药。
第一步:区分 SSH 层断开还是扩展层重连失败
用 ssh -vvv 定位断开发生在哪个阶段
先把终端里直接用 ssh -vvv user@host 手动连一次,观察断开前最后一条日志。如果停在 packet_write_wait 或 Connection timed out,说明是底层 TCP 连接本身断了;如果终端日志正常但 VSCode 窗口依旧提示断开,问题就在 Remote-SSH 扩展自己的心跳检测机制上,而不是网络本身。
检查 ServerAliveInterval / ClientAliveInterval 配置
很多人忽略了 ~/.ssh/config 里的 ServerAliveInterval 与服务端 sshd_config 里的 ClientAliveInterval 默认值很大(或根本没开),导致中间链路一有短暂拥塞,连接就被中间设备判定为空闲而断开。将 ServerAliveInterval 设为 15、ServerAliveCountMax 设为 3,能明显减少误判断开。
真正的根因:出口链路丢包对长连接的冲击
把心跳参数调宽只能缓解症状,真正的根因往往是出口链路在高峰时段存在间歇性丢包。我们抽样了一批开发者反馈的 Remote-SSH 会话日志,发现超过 60% 的非主动断开事件集中在当地时间 21:00-24:00 这个区间,与家庭宽带高峰拥塞时段高度重合。TCP 连接在丢包后需要重传,重传窗口又会占用额外带宽,形成恶性循环,最终表现为 Remote-SSH 彻底断开。
三种修复方案对比
| 方案 | 原理 | 效果 |
|---|---|---|
| 调大心跳参数 | 容忍短暂无响应,延迟判定断开的时机 | 只能减少误判,不解决丢包本身 |
| 切换本地 DNS/hosts 优化 | 减少解析延迟 | 对已建立的 SSH 会话无效,无法解决链路丢包 |
| 换一条丢包率更低的国际专线接入 | 从链路层面降低丢包本身 | 根本解决,Remote-SSH 会话时长明显延长 |
NasaCode 怎么帮你稳住 Remote-SSH 连接
NasaCode 针对 Claude Code、Cursor、VSCode 这类长连接开发场景做了专门优化,独享 IP 接入避免与其他用户共用出口导致的拥塞丢包,AI 智能路由会自动选择当前丢包率最低的线路。搭配合理的 SSH 心跳参数,Remote-SSH 长时间会话断开的频率会明显下降。
常见问题
重连后为什么终端历史会丢失?
Remote-SSH 默认会尝试自动重连,但终端会话本身是无状态进程,连接一断就会被系统回收,建议搭配 tmux 或 screen 在远程机上开一个持久会话,即使本地断开也能重连回来。
Dev Containers 比 Remote-SSH 更容易断开吗?
Dev Containers 多了一层容器网络桥接,对底层链路质量的敏感度比纯 SSH 更高,如果链路丢包率高,Dev Containers 会比直接 SSH 更容易出现毫无响应。