开发机分流规则怎么写:先把流量分成三类再动手
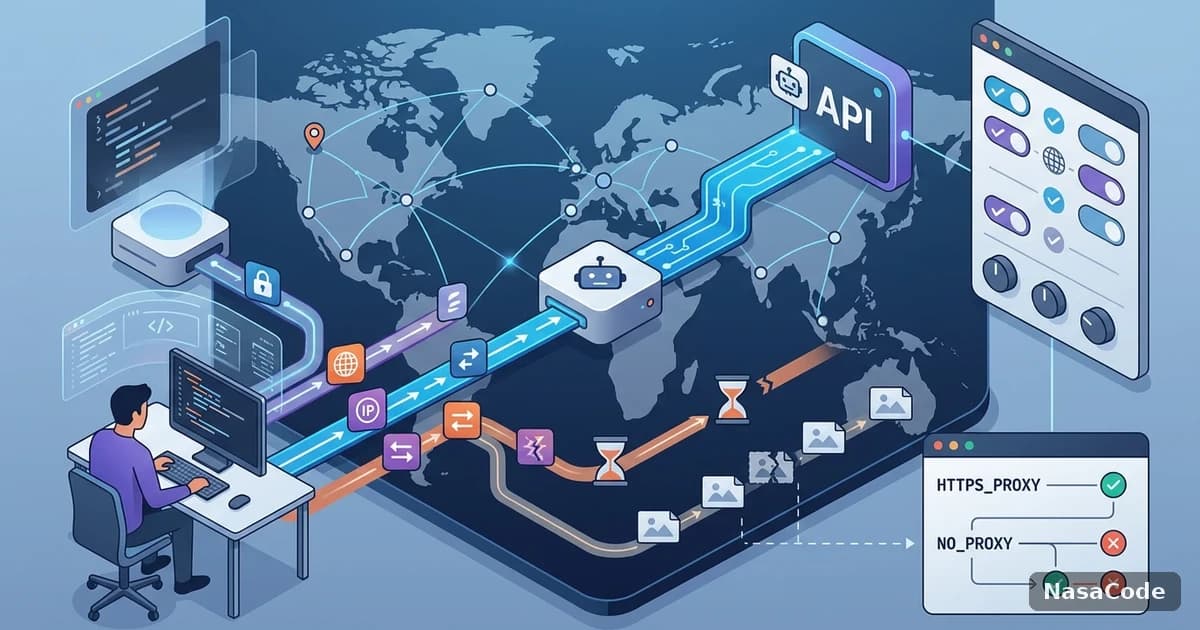
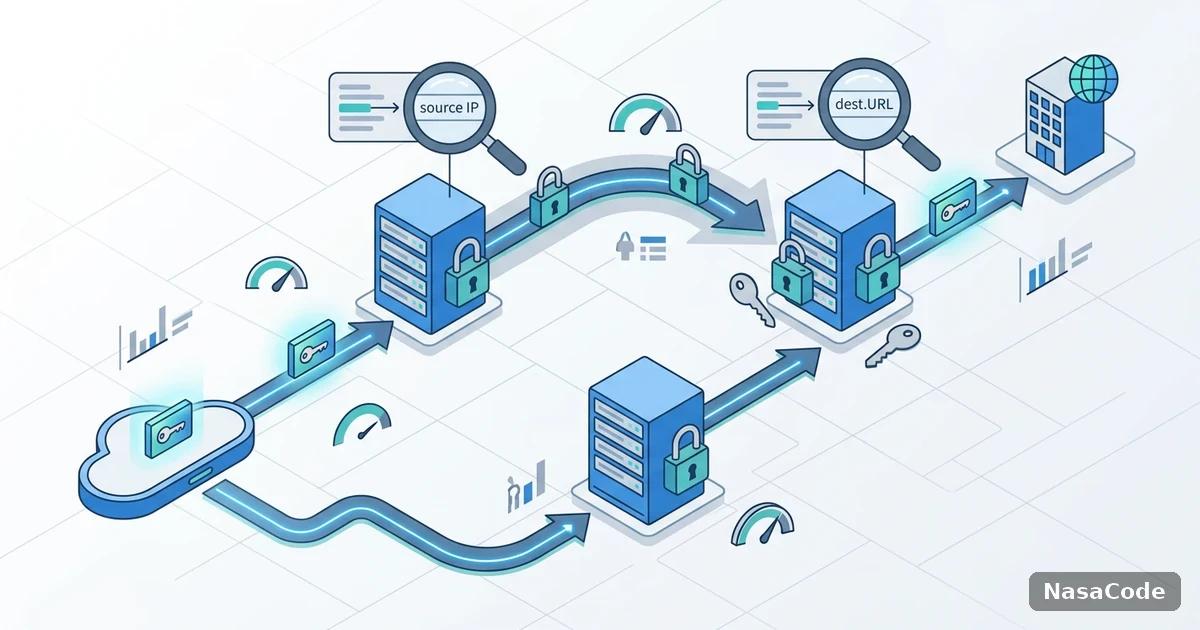
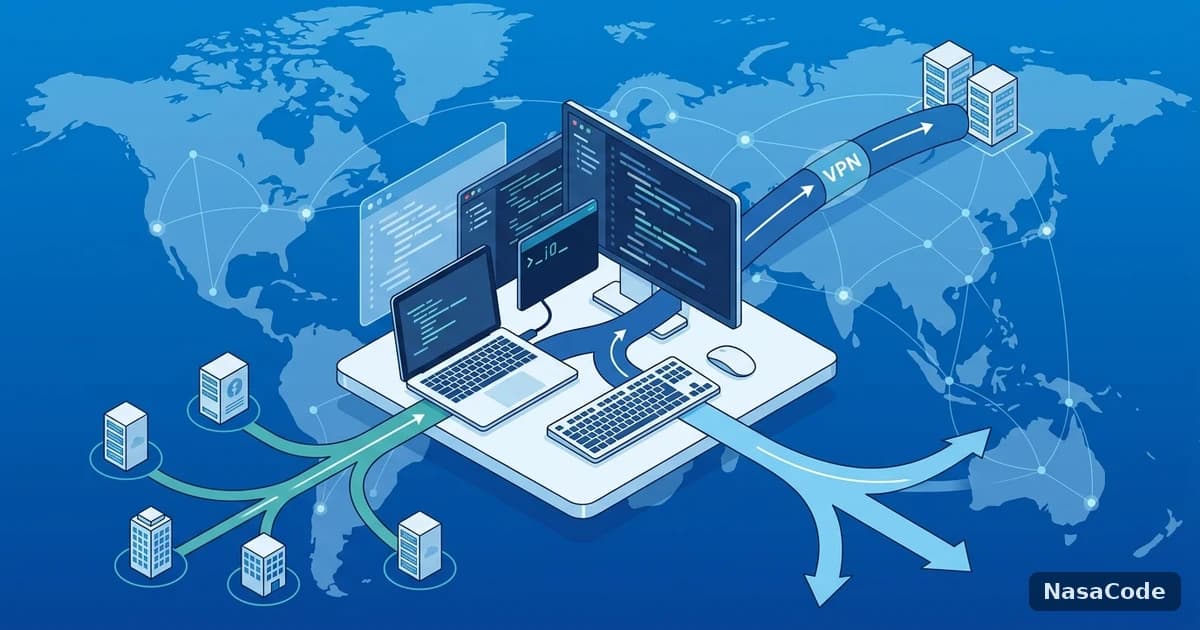
开发机的分流规则,核心是回答一个问题:每一个出站连接,该从隧道出去,还是从本地网卡直接出去。写之前先把你每天会碰到的流量分成三类——必须直连的(公司内网、局域网设备、本机回环)、必须走隧道的(需要稳定跨境访问的 AI 工具、代码托管、依赖仓库),以及无所谓的(其余网页和更新检查)。多数「分流不生效」或「内网突然连不上」的问题,都是因为没有先做这份清单,上来就抄一套别人的规则。本文只讲规则本身怎么落地与验证,分流的基本概念可以先看分离隧道是什么,这里不重复。

三类规则各自的取舍:域名、网段、进程
常见的分流规则按匹配对象分三种,适用场景不同,混着用时要清楚各自的盲区。
按域名分流适合什么,漏洞在哪
域名规则写起来最直观,比如让某个 AI 服务的域名走隧道。它的弱点是依赖解析结果:客户端必须先拿到域名对应的 IP 才能决定走哪条路,如果这次解析发生在隧道之外、返回的是另一批地址,规则就可能对不上。大型服务背后常有多个域名和 CDN 地址,只写主域名会漏掉静态资源、下载域名和 API 子域名。
按网段分流适合什么,漏洞在哪
网段规则(CIDR)直接作用在路由表上,行为确定、与解析无关,最适合内网和云厂商的固定地址段。以 WireGuard 为例,AllowedIPs 既决定哪些目的地址的流量发往对端,wg-quick 也会据此安装路由,所以想只让某几个网段走隧道,就只写这几个网段,而不是 0.0.0.0/0。缺点是公共服务的地址会变动,写死之后要定期复核。
按进程分流适合什么,漏洞在哪
按应用或进程分流能让某个编辑器、某个命令行工具单独走隧道,对不方便改配置的软件很省事。但它依赖客户端在系统层识别进程,容器、虚拟机、在终端里由别的进程拉起的子进程,常常不被识别到。Docker 容器里的流量尤其容易漏网,需要单独验证。
| 规则类型 | 确定性 | 维护成本 | 常见漏网点 |
|---|---|---|---|
| 域名 | 依赖解析结果 | 要补全子域名与 CDN 域名 | 解析发生在隧道之外 |
| 网段 CIDR | 由路由表直接决定 | 公共地址变动需复核 | 地址段写太宽,误伤内网 |
| 进程 | 依赖客户端识别进程 | 新增工具要补进程名 | 容器、子进程、虚拟机 |
开发机的直连清单与规则顺序
先写直连清单,再写走隧道的清单,最后留一条兜底。直连清单至少应包含:本机回环、局域网私有网段、公司内网域名与网段、内部镜像仓库和代码托管域名。私有网段的标准写法是 10.0.0.0/8、172.16.0.0/12、192.168.0.0/16,如果公司使用其他内部网段也要加上。
- 最前面放直连规则:私有网段、内网域名、本机回环,保证它们不会被后面的宽规则吃掉。
- 中间放走隧道的规则:需要稳定访问的具体域名或网段,写得越具体越好。
- 最后一条兜底:未命中任何规则的流量,是直连还是走隧道,要有明确的取舍,不要依赖客户端默认值。
- 同一目标被多条规则匹配时,多数实现按从上到下第一条命中的为准,写完要核对一次顺序;具体行为以所用客户端的说明为准。
规则怎么分组、怎么备份多个版本,可以参考NasaCode 分流规则的分组与云备份,思路同样适用于其他客户端:把规则按场景拆成组,改动之前留一份快照。
怎么验证规则真的生效了
规则写完不要凭「能打开网页」判断,用命令看实际走向。先确认目标地址到底落在哪张网卡上:
# macOS
route -n get 140.82.112.3

# Linux
ip route get 140.82.112.3

# 看连接实际使用的远端地址与耗时
curl -sS -o /dev/null -w "%{remote_ip} %{time_connect} %{time_appconnect}\n" https://example.com
示例中的地址只是占位,请换成你要验证的目标。输出里的 interface 或 dev 一栏如果是隧道接口,说明该地址走了隧道;是物理网卡,就是直连。对域名规则,要先用 dig 或 nslookup 取得解析结果,再对这些地址逐个检查,同时在隧道开启与关闭两种状态下各解析一次,看返回的地址是否一致。若不一致,问题往往不在分流规则,而在DNS 解析与出口 IP 的错位。
终端工具要单独验证
命令行工具读取的是环境变量里的代理设置,不一定遵守系统层分流。NO_PROXY 的写法在不同工具里并不统一:域名前是否带点、是否支持 CIDR 网段,curl、wget、Go 程序的行为都有差别,部分旧版本不识别网段写法。遇到某个工具仍然走了代理,先单独对它测试,写法可以对照代理与超时环境变量的写法说明。
常见漏网与误伤,怎么对着症状排查
下面几类现象在开发机上最常见,对应的检查动作也比较固定:
- 公司内网突然不通:先看是不是
0.0.0.0/0之类的宽规则排在了私有网段之前,或者内网域名被公共 DNS 解析成了外部地址。 - 容器里的请求没有走预期线路:容器有自己的网络命名空间和 DNS 配置,进程规则识别不到,需要在容器内部执行
curl单独验证。 - 某个 AI 工具一部分功能正常、一部分超时:多半是它的静态资源或登录域名没有列进规则,用浏览器开发者工具或抓包列出它实际访问的全部域名后补全。
- 规则改完没变化:已建立的长连接不会因为规则更新而切换路径,需要重启对应进程再测。
如果你的使用场景主要是让 Claude Code、Cursor 这类工具稳定直连,同时让内网与本地服务保持直连,NasaCode 把分流规则做成了可分组、可备份的形式,并带 AI 智能路由,可以减少手工维护域名清单的工作量;是否适合你的开发环境,仍然建议按上面的命令做前后对比。
小结
写分流规则的顺序是:先分类列清单,再按「直连、走隧道、兜底」排序,最后用路由查询命令和 curl 耗时验证。域名规则看解析、网段规则看路由表、进程规则看识别范围,各有盲区,混用时逐项检查,比一次性抄一套大而全的规则更可靠。