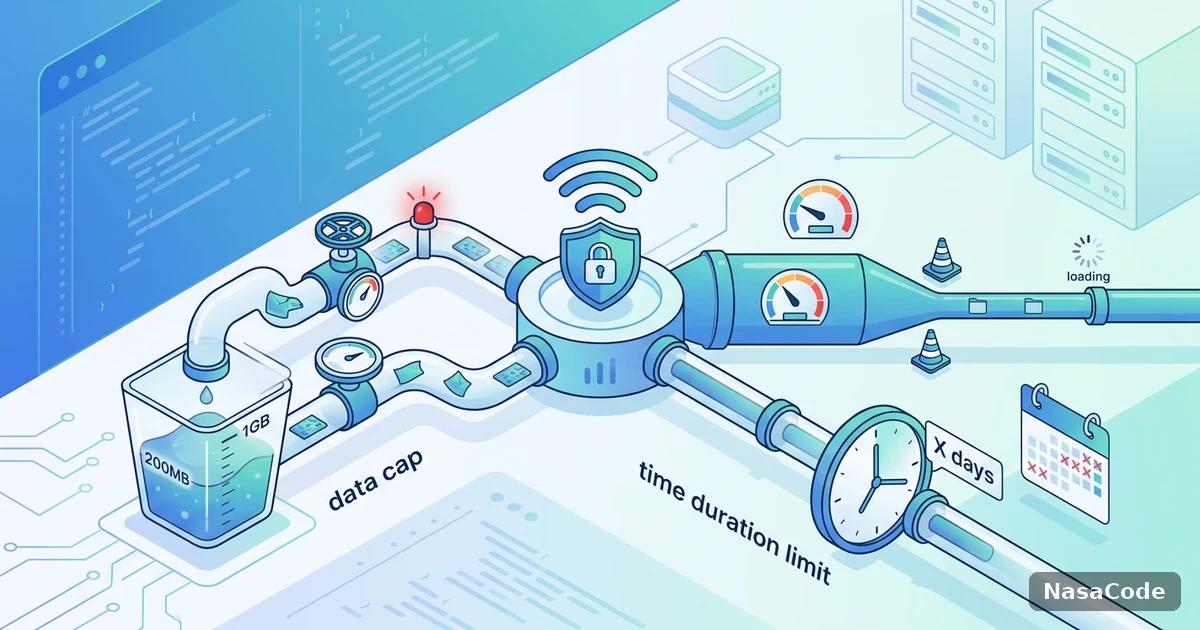
200MB是个中性数字,够不够用取决于场景
单看「200MB」这个数字很难判断多还是少——同样的额度,用来发几十条文字消息绰绰有余,用来看一段高清视频可能几分钟就见底。判断这个额度是否够用,需要先弄清楚它在不同数据量级的场景里各自能撑多久,而不是脱离场景抽象地讨论这个数字本身。这也是为什么同一个200MB的评价在不同人那里会截然相反:轻度用户觉得完全够用,重度用户觉得远远不够,两种感受都没错,只是场景不同。
一个简单的估算方法:先弄清楚自己的场景组合
与其纠结200MB是多是少,不如先列一份自己一天大概会用到的场景清单:查资料和文字沟通占多少比例,文档协同和邮件收发占多少比例,有没有视频通话或者代码仓库操作。把这几类场景按前面提到的量级粗略估算一遍,累加起来跟200MB对比,就能大致判断这份额度对自己是宽裕还是紧张,而不用等到用超了才发现设计的额度和自己的场景不匹配。这份清单最好按实际的一周使用习惯来估算,而不是只看某一天的特殊情况——工作日和周末的使用强度往往差异不小,只按其中一种情形估算容易得出偏差较大的结论。
不同类型请求的数据量级差异
纯文字类请求:数据量最小的一类
文字聊天、查资料、收发邮件这类以文本为主的请求,单次数据量通常只有几KB到几十KB,哪怕高频次使用,一天下来累计消耗往往也只是个位数到十几MB,是200MB里最经用的部分。
代码与依赖包拉取:容易被低估的中量级场景
开发者常见的 git clone、安装依赖包这类操作,单次数据量从几MB到几百MB不等,取决于仓库大小和依赖树复杂度。一次中等规模的依赖安装就可能占掉当日额度的相当一部分,这也是开发者更容易感觉「额度不经用」的原因——不是文字场景吃流量,是这类批量文件传输吃流量。如果项目依赖没有做好本地缓存,每次重新安装都要完整拉取一遍依赖树,反复执行几次同样的操作,消耗的流量很容易在不知不觉中叠加到一个可观的数字。
音视频类请求:数据量最大的一类
视频通话、在线视频这类场景是流量消耗最快的类型,尤其是开启摄像头之后,每分钟消耗的流量可能是纯文字场景一整天用量的好几倍。清晰度越高,这个差距会被进一步拉大——同样十分钟的视频通话,标清画质和高清画质消耗的流量可能相差好几倍,这也是为什么同样打着视频通话的旗号,不同人反馈的流量消耗会差异很大。
后台自动更新和推送:容易被忽略的隐性消耗
操作系统和应用商店经常会在后台自动检查更新、下载补丁包,这类流量不会体现在你主动发起的请求里,但同样会计入当天额度。如果连接期间恰好赶上系统推送了一次较大的更新包,哪怕你自己什么都没做,额度也可能被悄悄消耗掉一大块,这也是判断额度到底花在哪里时容易被漏掉的一个环节。

200MB大致能覆盖什么强度的使用
| 使用场景 | 数据量级 | 200MB大致可支撑 |
|---|---|---|
| 纯文字聊天/查资料 | 低 | 大半天间歇性使用 |
| 邮件收发/文档协同 | 中低 | 数十次访问 |
| 代码仓库/依赖包拉取 | 中到高(视规模而定) | 数次到十几次 |
| 音视频通话 | 高 | 数分钟到十几分钟 |
什么时候这个额度算「够用」,什么时候算「不够」
- 临时应急验证一条线路能不能连上、稳不稳定,200MB通常绰绰有余,可以反复测试很多轮。
- 日常轻量使用(文字沟通为主,偶尔查资料),200MB配合每日刷新,长期用下来也基本够用。
- 如果日常工作包含频繁拉取代码仓库、安装依赖包,或者需要用 Claude Code、Cursor 跑持续性的 agent 任务,200MB这类量级会很快显得吃紧——这类场景的数据量本身就不是「每天200MB」这个设计初衷要覆盖的对象。
- 如果家里或团队有多个人共用同一个免费账号,实际人均可用的额度会进一步被摊薄,原本看起来够用的200MB分给两三个人之后可能很快就不够看了。
- 系统和应用的后台自动更新如果恰好赶在使用高峰期触发,会和你手头正在做的事情一起抢占当天额度,进一步压缩实际可用的空间。
总结
200MB算多还是算少,答案取决于你把它放进什么场景。用来验证连通性或者做轻量日常沟通,这个额度相当宽裕;但一旦涉及频繁的代码仓库操作、依赖包安装这类中高数据量场景,就已经超出了每日免费额度的设计边界,这种边界感比纠结数字本身更有实际意义。NasaCode 提供不设每日流量上限的稳定线路,更适合把 Claude Code、Cursor 这类高频网络请求的开发工具当作日常主力使用的场景。