Claude Code 云端会话和本地 CLI,为什么断线的位置不一样
Claude Code 云端会话(claude.ai/code 或终端里的 claude --cloud)和本地 CLI 用的是同一套工具,但网络链路完全是两回事:本地 CLI 的每一次模型请求、每一次 git 操作都从你的电脑出发,经过本地网络和国际出口;云端会话则把执行环境搬进 Anthropic 托管的虚拟机,你的电脑只负责看进度、发指令。所以本地 CLI 多半断在「你到 API」这一段,云端会话多半断在「你到控制面」或「VM 自身的网络策略」。把这两条链路分开看,排查时间能省掉一大半。截至 2026 年 11 月,官方文档对两种模式的描述已经比较完整,本文据此整理。
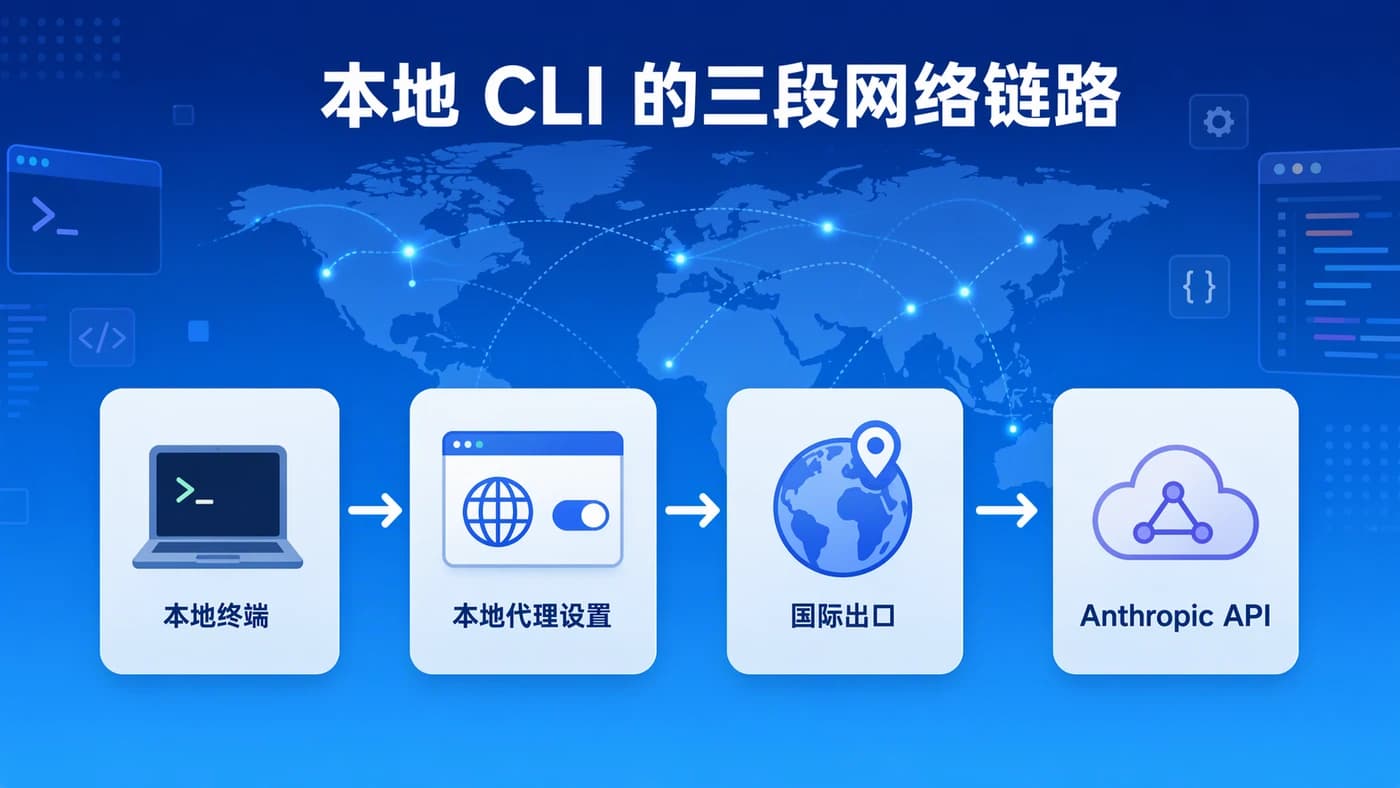
本地 CLI 的链路:三段都可能断
第一段:终端到 Anthropic API
本地 CLI 跑一个 agent 任务时,模型调用是流式长连接:请求发出后,响应以分块方式持续回传,一个复杂任务里这样的往返可能有几十次。这一段最怕的不是带宽小,而是国际出口抖动——丢包率不高,但 RTT 忽高忽低,流式响应中途几秒没有新字节,客户端等到超时就报 API Error 或 fetch failed。先用 curl -w 看一眼握手与首字节耗时:
curl -o /dev/null -s -w "dns:%{time_namelookup} tcp:%{time_connect} tls:%{time_appconnect} ttfb:%{time_starttransfer}\n" https://api.anthropic.com/如果 tls 经常超过 1 秒、ttfb 来回跳,问题就在这一段。开发者在这里通常有两种做法:挂代理环境变量,或者用带 AI智能路由 的全球加速VPN 让 api.anthropic.com 走一条更稳的出口。NasaCode 的分流规则可以只把这一类域名送进隧道,其余流量保持直连,不影响本地服务调试。
第二段:本地工具调用各走各的代理
Claude Code 在本地执行 git fetch、npm install、gh pr create,这些请求的代理设置互不相通。常见的坑是 HTTPS_PROXY 对 CLI 生效了,但 git 读的是自己的 http.proxy,npm 读的是 .npmrc,于是模型请求正常、依赖拉取却超时,日志里看起来像是「Claude 卡住了」。这一段的写法可以参考 Claude Code 代理与超时环境变量 一文。
第三段:MCP 与远程服务
如果配置了远程 MCP Server,它是另一条独立的 HTTP 连接,超时阈值和重试策略都与模型请求无关。MCP 超时在终端里表现为工具调用长时间无响应,而不是 API 报错,很容易被误判成模型卡顿。
Claude Code 云端会话的链路:断点换了地方
你的浏览器到控制面
云端会话的执行发生在 Anthropic 管理的 VM 里,VM 直接从所在数据中心访问模型 API,完全不经过你的本地网络。所以你本地出口再差,也不会让 VM 里的 agent 任务超时。你能感知到的「断」,其实是浏览器与 claude.ai 之间的实时连接掉了:页面停在旧状态、新消息发不出去。官方文档把新会话起不来的情况写成「Connection lost」,建议检查本地网络和正在使用的代理。这一段只影响观看和发指令,VM 里的任务通常还在跑,刷新页面就能回到最新状态。
VM 自身的网络策略
云端会话的对外访问由「云端环境」配置控制,默认是受限的 Trusted 级别,带一份默认允许域名列表。任务如果要去拉一个不在允许列表里的私有 registry,会在 VM 内直接失败——这不是抖动,是策略拒绝,换本地出口也没用。GitHub 操作走官方的 GitHub 代理,凭据在服务端附加,不进入 VM。
环境过期
云端会话空闲一段时间后 VM 会被回收,文档称为 Environment expired。重新打开会话能恢复对话历史,但当时正在跑的 shell 命令、子代理、会话内的定时任务都不会恢复,需要让 Claude 重新执行。这是云端会话特有的「断」,本地 CLI 不存在这个问题。
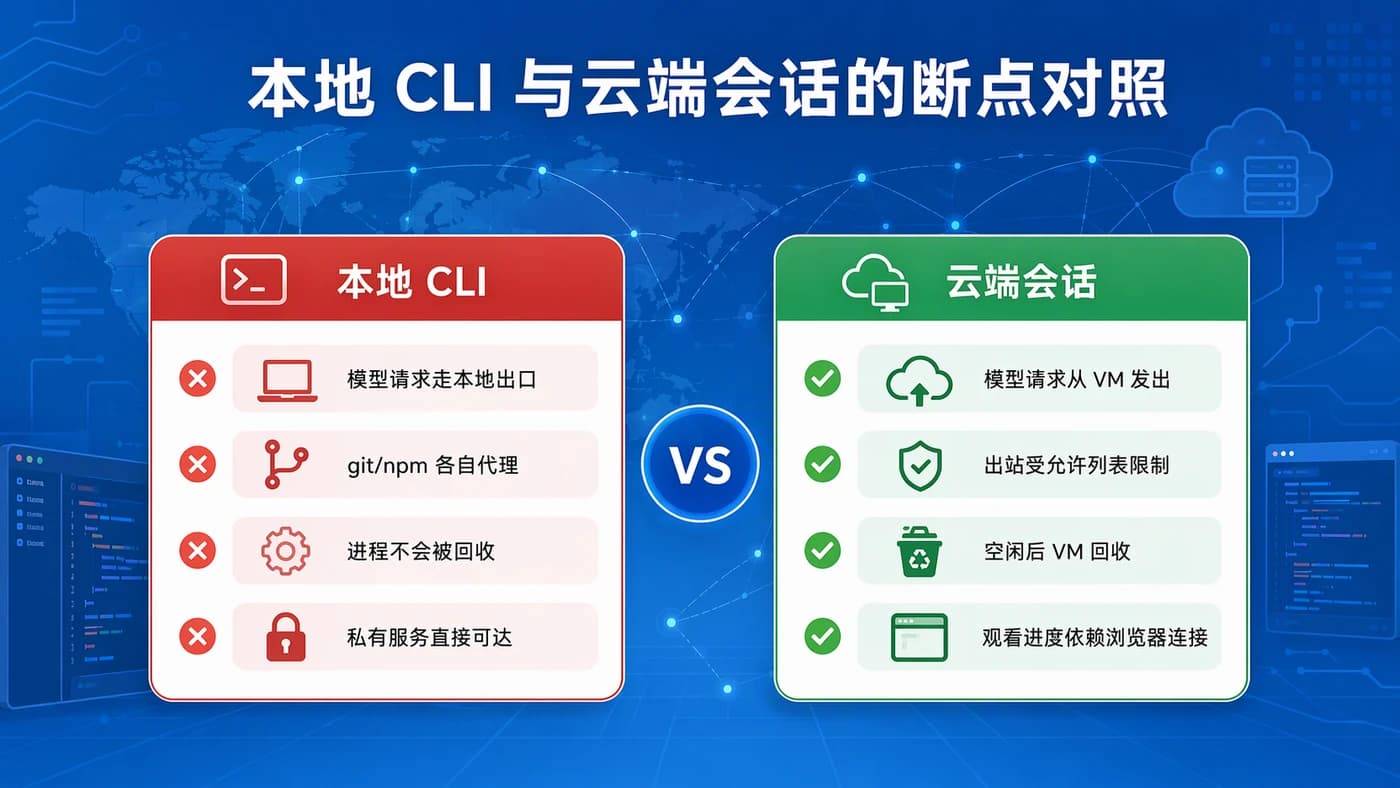
两种模式的断点对照
| 环节 | 本地 CLI | Claude Code 云端会话 |
|---|---|---|
| 模型 API 请求 | 从你的电脑经国际出口发出,受本地网络影响 | 从 Anthropic VM 发出,与本地网络无关 |
| git / 依赖拉取 | 走本地代理设置,git、npm、pip 各自独立 | 走 VM 的允许列表与 GitHub 代理 |
| 观看与发指令 | 就在终端里,不存在额外链路 | 浏览器到 claude.ai 的实时连接,本地网络差会掉 |
| 长时间空闲 | 进程还在,不会被回收 | VM 过期回收,后台命令与子代理丢失 |
| 私有服务访问 | 与本机同一网络,直接可达 | 默认受限,需要配置允许域名 |
--cloud 与 --teleport 切换时的网络动作
两种模式之间切换也有各自的网络依赖。claude --cloud "任务描述" 不会上传你的本地工作区,VM 是从 GitHub 克隆当前分支,所以必须先 push;没推上去的提交和未提交的修改都不在云端。反过来,claude --teleport <session-id> 会把云端分支 fetch 到本地,这一步走的是本地 git 到 GitHub 的链路,文档明确写了 fetch 不会等待交互输入,ssh 要求口令或确认新主机时直接失败。所以 teleport 之前要做的事很具体:
- 确认工作区干净,否则会被提示先 stash。
- 确认当前目录是同一个仓库的 checkout,而不是 fork。
- 如果用 ssh 远程,先把密钥加载进 ssh-agent,并手动跑一次
git fetch记录主机指纹。 - 再执行 teleport,让它自动 fetch 并切到云端分支。
如果本地到 GitHub 的链路本来就慢,teleport 会卡在 fetch 这一步,而不是卡在会话加载。给 git 单独配代理、或者让 github.com 走加速通道,都能让这一步稳定下来。与之相关的上下文恢复思路见 长任务中途断线怎么完整恢复上下文。
按症状对号入座
- 本地 CLI 报 API 错误、流式输出中途停住:第一段出口抖动,跑 curl 计时,考虑让 API 域名走稳定出口。
- 本地 CLI 模型正常但 git / npm 超时:第二段代理不一致,逐个检查 git config、.npmrc、pip.conf。
- 云端会话页面不更新、发不出消息:浏览器到控制面断了,刷新页面;任务大概率还在跑。
- 云端会话里某个下载直接失败:VM 允许列表拒绝,去云端环境配置里加域名,不是网络问题。
- 云端会话重开后后台任务没了:环境过期,让 Claude 重跑被中断的命令。
更完整的本地 agent 任务断线排查步骤,可以对照 Claude Code 长任务频繁断线排查指南。
常见问题
我本地网络很差,云端会话会不会跟着失败?
不会让任务本身失败。VM 内的模型请求和 git 操作不经过你的网络,你只会在观看进度和发指令时掉线,刷新即可。但起新会话、提交 prompt 的那一下依赖本地连接,网络差时会提示 Connection lost。
本地 CLI 配了代理,云端会话还要配吗?
不需要,也配不到。云端会话的出站访问由云端环境的允许域名列表决定,本地的 HTTPS_PROXY 对它没有任何作用。
两种模式能混着用吗?
可以,官方推荐的用法是本地 plan mode 规划、推送后用 --cloud 执行,完成后 teleport 回本地继续。只要记住 push 在前、teleport 要干净工作区即可。
总结
本地 CLI 的断线在你的网络出口,云端会话的断线在控制面和 VM 策略,两者的修法完全不同。对本地 CLI 来说,给 api.anthropic.com 和 github.com 一条稳定的出口是最直接的改善。NasaCode 提供面向 Claude Code、Cursor 等开发工具优化的全球加速VPN,支持 AI智能路由 与分流规则,每天有 200MB 免费额度可以先把这条链路测一遍。