MCP CLI 调用为什么会超时?
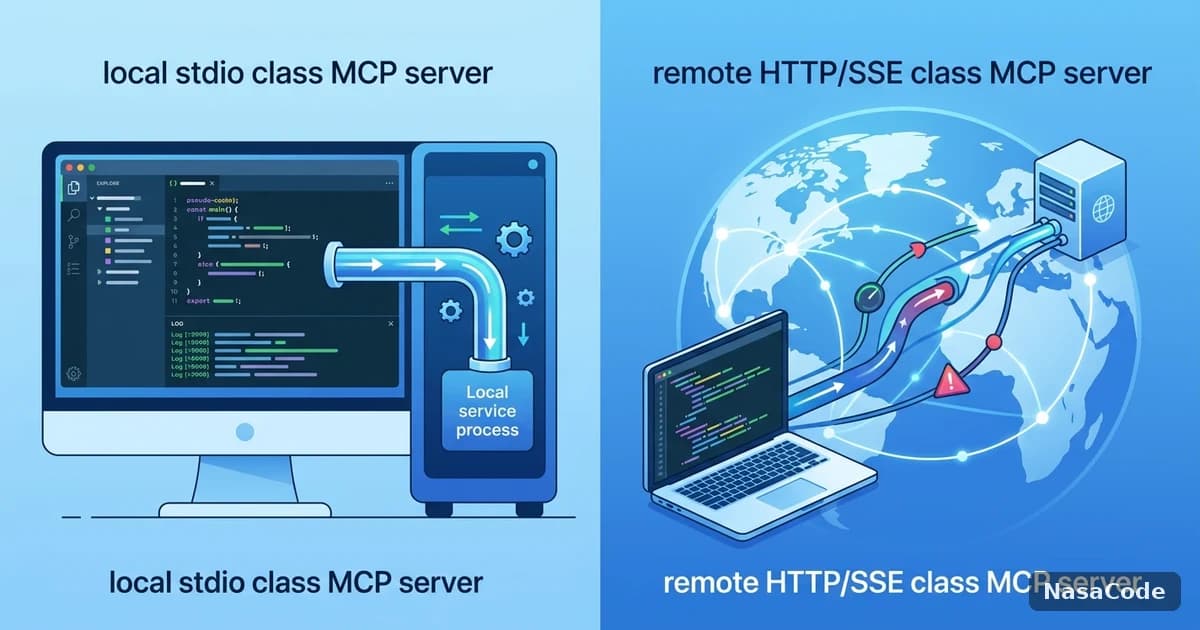
MCP(Model Context Protocol)CLI 调用超时的本质,是客户端发出的 JSON-RPC 请求在约定的时间窗口内没有拿到 server 端完整响应。超时可能出现在三个环节:本地进程与 MCP server 之间的通信管道、CLI 客户端自身设置的超时阈值、以及请求实际经过的网络出口链路。排查前先判断问题出在哪一环,比直接调大超时时间更有效——阈值调大只会把报错变成长时间无响应,并不能消除根因,反而会拖慢问题定位的速度。
MCP Server 连接不稳定的常见诱因
网络链路波动
跨境网络链路的丢包与抖动是最常见的一类诱因。MCP 请求通常基于长连接或流式传输,一旦链路中间某一跳出现丢包重传,原本几十毫秒的往返时延可能瞬间拉长到数百毫秒甚至数秒,超过 CLI 客户端默认的超时阈值就会直接报错断开。这类问题的典型表现是:同一条请求偶尔成功、偶尔超时,重试几次又能通过,报错时间点没有明显规律,和本地负载、请求内容本身都没有直接关系。
Server 端资源与并发瓶颈
如果 MCP server 本身在处理长任务,比如一次工具调用触发了大量文件读写或外部接口请求,而 CLI 客户端又在同一时间发起了多个并发调用,server 端的请求队列可能会被打满。此时新请求要等待前面的任务释放资源才能被处理,等待时间一旦超过客户端超时阈值,表现出来的就是调用超时,但根因其实是 server 端排队,而不是网络本身有问题,盲目重试反而会加重排队。
客户端配置与超时阈值设置不当
部分 CLI 工具的默认超时阈值是按本地或同区域网络设计的,对跨境访问场景可能偏短。如果没有针对实际网络环境调整超时和重试参数,即便 server 端和网络本身都正常,单次响应时间略长于默认阈值也会被判定为超时。这类问题的特征是:延迟其实并不算特别夸张,但只要超过某个固定数值就必然报错,而不是随机出现,调整阈值往往比排查链路更快见效。
如何定位——本地环境问题还是网络链路问题
区分本地问题和网络问题,最直接的方法是做交叉对比。先在本地直接调用 MCP server 提供的健康检查或最简单的工具接口,如果本地调用也慢或者失败,大概率是 server 进程本身有问题,比如进程卡住、资源耗尽或日志里已经出现异常堆栈;如果本地调用正常,但通过网络访问同一 server 就超时,问题基本可以锁定在链路上,后续排查方向也会完全不同。

- 先看 CLI 客户端日志:定位超时报错前最后一条日志的时间戳,判断卡在建连、发送还是等待响应阶段
- 用基础网络工具检查到目标 server 所在机房的路由跳数与丢包率,重点看是否有某一跳丢包骤增
- 在同一网络环境下,单独测试最简单的健康检查请求,排除是不是具体工具调用本身耗时过长导致的假性超时
- 对比不同时间段的表现,如果只在特定时间段集中出现超时,更像是链路拥塞而非配置问题
CLI 工具调用超时的分步排查方法
- 先复现问题:记录超时发生的具体命令、时间点和完整报错信息,确认是必现还是偶发
- 检查本地进程状态:确认 MCP server 进程是否存活、端口是否被正常监听,避免进程本身已经异常退出
- 核对超时与重试配置:查看 CLI 客户端配置文件中的超时时长、重试次数是否符合实际网络延迟水平
- 测试网络链路质量:用基础网络工具检测到目标地址的时延和丢包情况,判断是否为链路问题
- 分离并发影响:如果同时有多个工具调用在跑,尝试单独执行,观察超时是否只在并发场景下出现
- 逐步调整参数验证:每次只改一个变量,比如超时时长、重试次数或并发数,观察对结果的实际影响,避免同时改多项导致无法定位根因
常见超时与失败场景对比
| 场景 | 典型表现 | 可能原因 | 应对方向 |
|---|---|---|---|
| 偶发超时,重试可通过 | 同一请求时快时慢 | 网络链路抖动或丢包 | 优化出口链路稳定性,适当增加重试次数 |
| 特定时段集中超时 | 某几个时间段高发 | 链路拥塞或 server 并发过高 | 错峰调用或提升 server 处理能力 |
| 本地调用也异常 | 不经过网络也慢或报错 | server 进程卡住或资源耗尽 | 检查 server 日志与资源占用,必要时重启进程 |
| 固定阈值必现超时 | 延迟略高于某个数值就报错 | 客户端超时阈值设置过短 | 结合实际网络延迟调整超时和重试参数 |
长期稳定性优化建议
从被动排查到主动监控
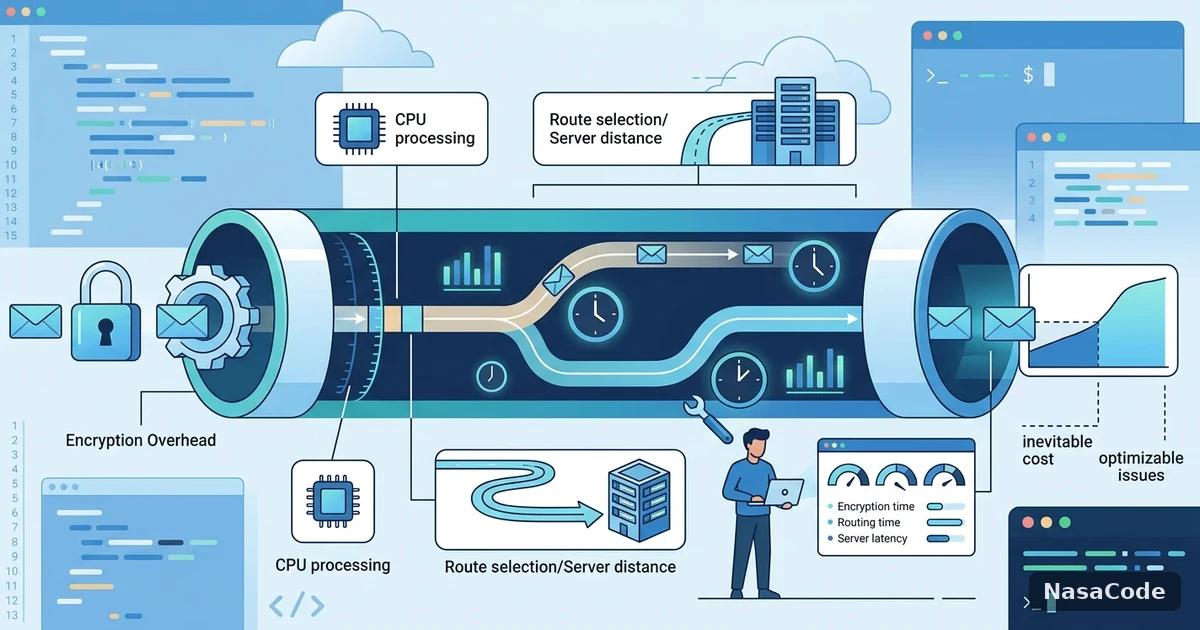
单次排查解决的是眼前问题,但 MCP 调用链路的稳定性更依赖长期监控。给关键工具调用加上耗时记录和失败率统计,能在问题扩大之前发现链路质量下降的趋势,而不是等到调用大面积失败才回头翻日志。团队内部测试环境中观察到,同一 MCP server 请求直连海外机房时,平均往返时延多在 350 到 600 毫秒区间,一旦链路出现抖动,瞬时时延可能升到 2 到 3 秒,远超多数 CLI 客户端默认的超时阈值,这也是超时集中爆发的常见触发点。
出口链路稳定性是容易被忽视的一环
对于长期跨境访问 MCP server 或调用海外接口的开发场景,出口链路本身的稳定性往往比反复调大超时阈值更关键。这一步遇到的摩擦通常是:同样的代码在本地网络环境下运行正常,一旦请求要经过不稳定的跨境出口,重传和排队就会反复触发超时,尤其是在 Claude Code 这类会连续执行多步工具调用的长任务场景里,一次链路抖动就可能打断整个任务链。把 IDE 与 MCP server 之间的出口链路单独固化下来,是不少开发者会考虑的方向,NasaCode 面向这类场景提供专用接入线路,减少链路层面的不确定性,但配置层面的超时与重试参数仍然需要按前面的方法逐项核实,两者并不互相替代。
总结
MCP CLI 调用超时看似只是一条报错,根因往往落在链路、并发、配置三者之一,按上文步骤逐项排除,大多数场景都能定位到问题所在;若长期受跨境链路波动困扰,把出口链路稳定性单独作为一项优化也值得纳入考虑。