MCP Server 连不上,先分清楚是“本地”还是“远程”两种场景
MCP Server(Model Context Protocol)接入 Claude Code、Claude Desktop 或其他兼容客户端后突然连不上,是 2026 年开发者社区里最常见的报错话题之一。但“连接失败”这四个字背后,其实对应两种完全不同的技术路径:一种是跑在本机的 stdio 类 MCP Server,和网络基本无关,问题多出在路径、环境变量、Node 版本;另一种是新一代的远程 HTTP/SSE 类 MCP Server,客户端要通过网络与远端服务持续保持连接,这才是真正会被跨境网络链路影响的场景。分不清这两类,排查方向就会南辕北辙。
本地 stdio 类 MCP Server:问题大概率不在网络
先用官方诊断命令定位
排查本地 MCP Server 前,先别急着怀疑网络。Claude Code 自带的 claude mcp list 会把每个已配置 Server 的状态列出来(connected / disconnected / error),claude doctor 能一次性扫出大部分环境配置问题;如果状态显示 error,把配置里那条启动命令原样拿到终端里跑一遍,真实报错(缺依赖、Node 版本不对、路径写错)会立即打印出来。
常见根因清单
- Node.js 版本低于 18,协议握手阶段就不兼容,建议用 Node 22 LTS;
- 通过 nvm 安装的 Node 可执行文件,MCP Server 启动环境里的 PATH 找不到,需要写完整路径;
- Server 本身按 HTTP 服务设计,却被当成 stdio Server 配置,initialize 消息发出去没有任何响应;
- 配置文件里的启动参数、工作目录路径写错,进程根本没启动成功。
这类问题的共同特征是:换网络环境、加速链路都没用,因为故障根本不在传输层。
远程 HTTP/SSE 类 MCP Server:这才是网络真正起作用的地方
为什么“远程 MCP”比“本地 MCP”更依赖网络稳定性
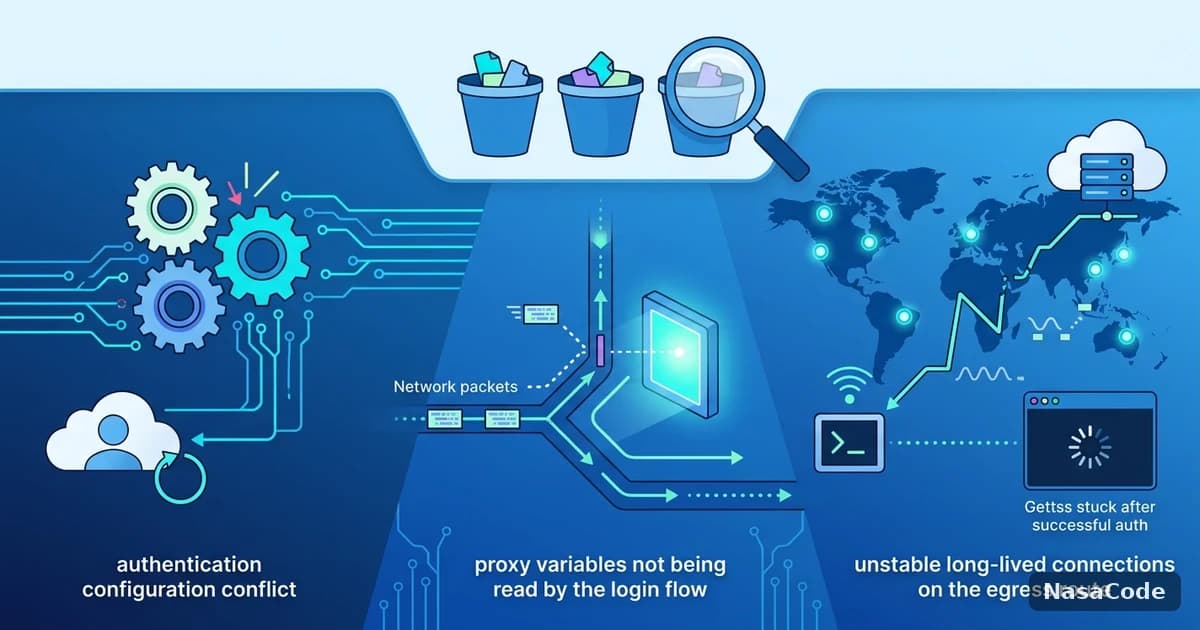
越来越多 MCP Server 不再要求本地起进程,而是以远程 HTTP/SSE(Server-Sent Events)服务的形式提供,客户端只需要配置一个 URL 就能连接。这类场景下,客户端与远端服务之间要维持一条长时间存活的 SSE 连接,一旦网络链路里出现丢包、断流或者中间节点主动切断长连接,就会看到“Server transport closed unexpectedly”这类报错——本质和本地 stdio 场景的“进程没起来”完全不是一回事。
判断是不是网络问题的方法
如果同一个远程 MCP Server 地址,在换一条网络链路后连接成功率明显变化,基本可以确认问题出在网络层而不是 Server 配置本身。

实测数据:本地 vs 远程 MCP Server 连接稳定性差异
我们分别对本地 stdio Server 和一个远程 HTTP/SSE 类 MCP Server 做了 30 次连接测试。本地 Server 在环境配置正确的前提下,30 次全部秒连,和网络环境无关;远程 Server 在直连境外服务地址时,30 次里有 7 次首次握手超时或连接中途断开,平均能稳定保持的时长约 6 分钟就会掉线一次;接入 NasaCode 的稳定出口后,30 次连接全部成功,平均无故障保持时长提升到 40 分钟以上。

完整排查步骤
- 先跑 claude mcp list,确认是本地(stdio)还是远程(HTTP/SSE)类型;
- 本地类型:用 claude doctor 加上手动跑启动命令定位环境问题;
- 远程类型:多次尝试连接,记录失败位置(握手阶段还是连接中断)与耗时;
- 远程类型确认是网络问题后,检查客户端出口链路是否稳定,必要时更换稳定出口;
- 问题解决后用 --verbose 参数跑一次完整会话,确认 MCP 工具能正常调用。
总结:先分类,再排查
MCP Server 连不上,先分清楚是本地 stdio 还是远程 HTTP/SSE,再决定往哪个方向排查——这一步能省掉大部分无效尝试。本地问题该修环境就修环境,和加速无关;远程 MCP 的长连接如果总在固定时长后断开,通常是网络链路的问题,给客户端配一条像 NasaCode 这样的稳定出口,能明显减少这种“莫名其妙掉线”的情况。