遇到 Claude Code 连接超时,很多人第一反应是重装客户端,或者怀疑 API Key 出了问题。折腾一圈,往往一无所获。
原因很简单:命令行工具是好的,模型也在线。卡住的是底层那条 HTTP 流——它没能在默认的请求窗口里把数据传完,于是在一段长时间的停顿后失败。对那些离 API 服务器较远的开发者来说,瓶颈几乎永远在网络链路上:偏高的往返延迟、拥塞路径上的丢包,还有中途被掐断的 TLS 连接。
精简上下文、换个更轻的模型、重启会话,这些应用层的招数能救一部分超时。但有一种情况它们全都不管用:同一条命令,在 A 网络下能跑完,换到 B 网络就超时。这种时候,差别不在你的提示词,而在数据包走的那条路。这篇就把这一层讲透。
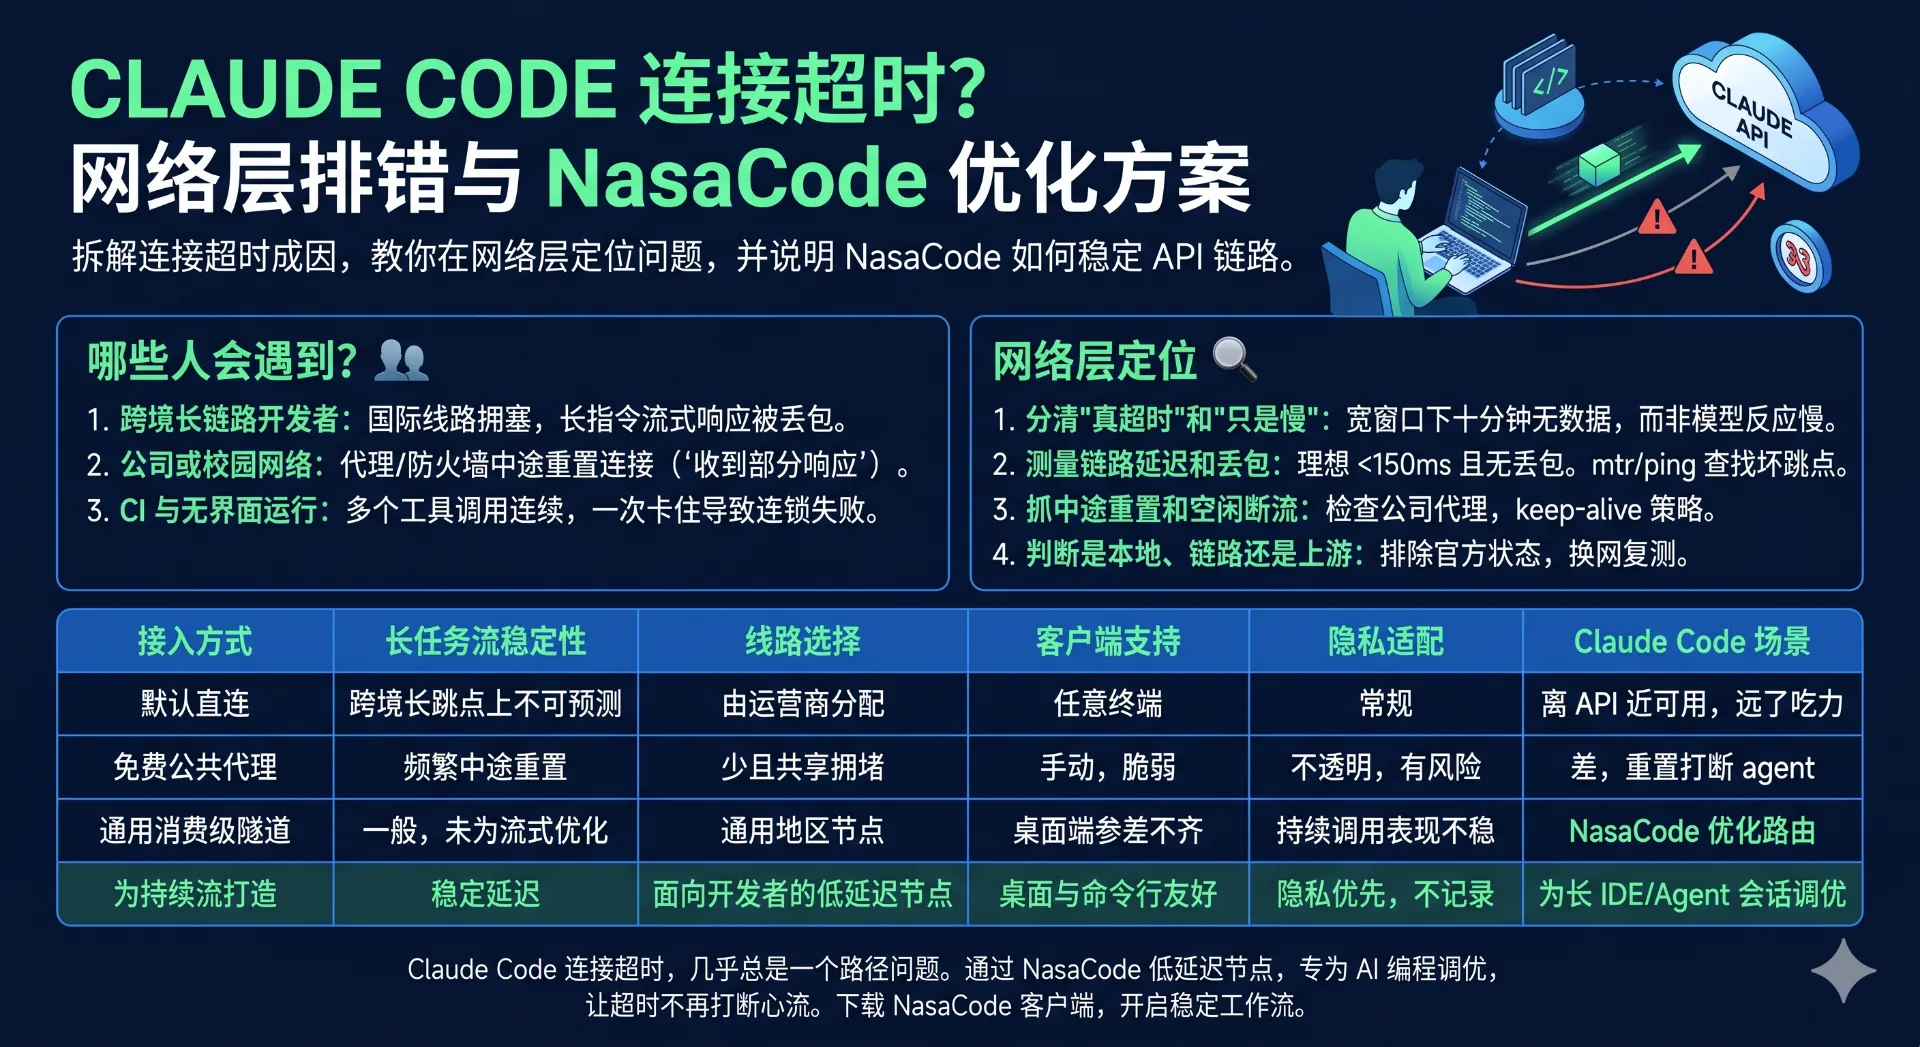
哪些人最容易撞上超时
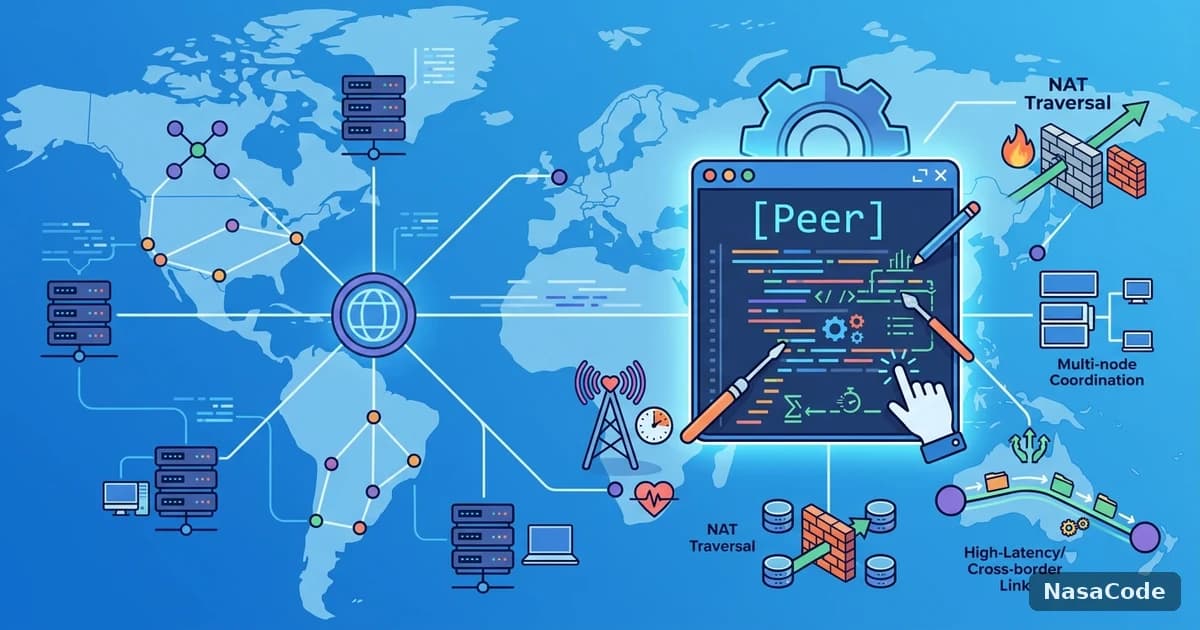
跨境长链路的开发者首当其冲。流量要先穿过一段又长又挤的国际线路才能摸到 API。做大型重构时,光标半天不动,最后蹦出一句"请求超时"——可前面那些短指令明明都正常。模型其实一直在生成,只是回传的 token 流在丢包的路上推不动而已。
公司网和校园网是另一类高发区。这里的连接经常在响应到一半时被重置,也就是那条让人摸不着头脑的"收到部分响应"。要么是中间的代理把流式数据缓冲坏了,要么是某条空闲策略太激进,刚一停顿就把它判定为闲置连接给关了。
还有一种是 CI 和无界面运行。一个 agent 连着发几十次工具调用,只要其中一次往返卡死,整条任务就跟着崩。
三种场景,病根是同一个:请求始终没能干净地走到结束,客户端等不下去,只好放弃。
把超时定位到网络层
先分清是"真超时"还是"只是慢"
动手前先确认失败的性质。Claude Code 给每次请求留的窗口相当宽,默认在十分钟量级。所以一次真正的连接超时,意味着这十分钟里流没产出任何可用结果,而不是模型反应慢了点。
先跑 claude --version 确认版本不老,再用 /doctor 做一次体检,大部分配置类问题它都能照出来。然后发一句最简单的提示试试。如果小请求秒回、偏偏大型 agent 任务超时,那链路本身是通的——问题在于这条弱链路扛不住大流量,不是服务挂了。
量一量延迟和丢包到底有多糟
这一步,大多数排错教程会直接跳过。它恰恰是关键。
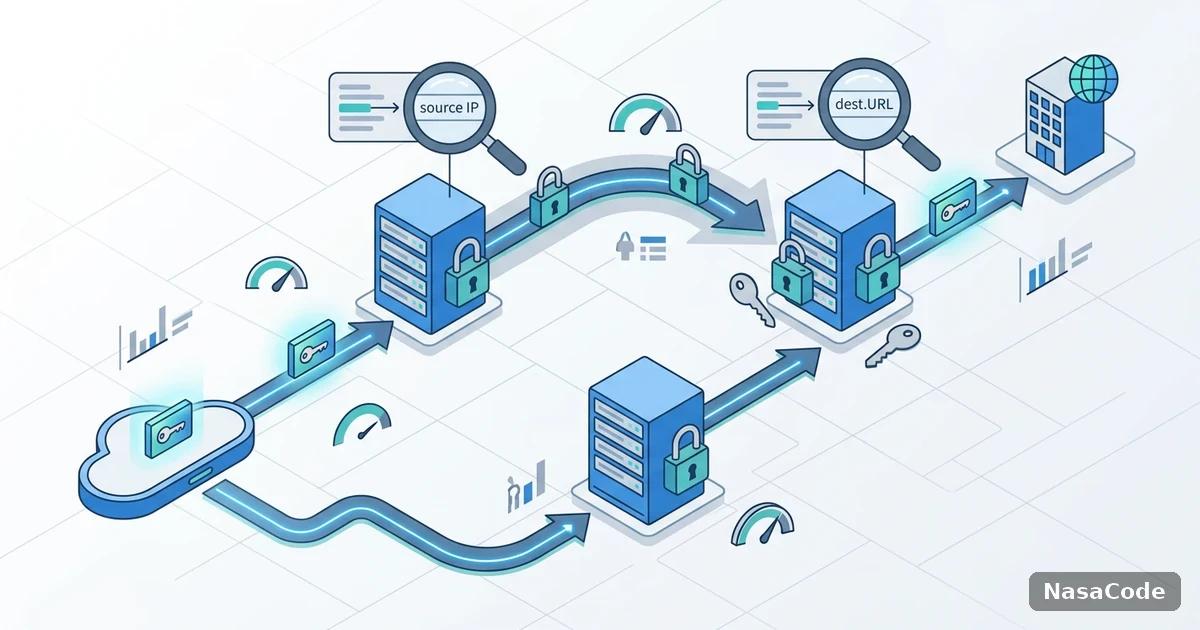
用 ping 测到 API 主机的基准往返时间,再用 traceroute 或 mtr 看丢包是从哪一跳开始冒出来的。交互式写代码,往返时间最好稳定压在 150 毫秒以内、基本不丢包。一旦超过 250 毫秒、再加上某个中间跳点间歇性丢包,流式响应就开始卡顿,长调用也跟着触发超时。
抖动和纯延迟一样要命。一条在 80 毫秒和 400 毫秒之间来回横跳的路径,会让流毫无规律地断掉。要是 mtr 把丢包指向某个运营商的跳点,那就是路径本身坏了——再怎么调客户端参数,也救不回一条坏路。
抓现行:中途重置和空闲断流
"收到部分响应"是连接层的特征,不是模型在报错。它的意思是:承载流式答案的那条 TLS 连接,在最后一个 token 到达之前就被切断了。常见元凶是一个会缓冲的代理,或者一条"模型一停下来思考就掐连接"的空闲策略。
查三件事:是不是有公司代理横在流量前面;keep-alive 有没有被剥掉;同一条提示换个网络能不能跑完。如果换掉公司线路后这种重置就消失了,那基本可以把锅扣到那条路径上。
分层排除:本地、链路,还是上游
按顺序往下排。官方状态页先看一眼,能告诉你 API 自身是不是在降级;要是绿的,故障就在应用层以下了。接着换手机热点或另一个网络复测一次——只要 Claude Code 连接超时随之消失,那你平时用的那条主线路就是病灶。
NasaCode 处理的正是中间这一层。与其让数据包在拥塞的默认路径上乱撞,不如把流量固定到一条延迟更稳、丢包更低的优化路由上,让流活得够久,大型 agent 任务才有机会跑到底。
几种接入方式,差在哪
| 接入方式 | 长任务流稳定性 | 线路 | 客户端 | 隐私 | 适配 Claude Code |
|---|---|---|---|---|---|
| 默认直连 | 跨境长跳点上难以预测 | 由运营商随机分配 | 任意终端 | 常规 | 离 API 近时够用,远了吃力 |
| 免费公共代理 | 频繁中途重置 | 少且共享拥堵 | 手动配置,脆弱 | 不透明,放密钥有风险 | 差,重置会打断 agent |
| 通用消费级隧道 | 一般,未针对流式优化 | 通用地区节点 | 多为桌面端 | 参差不齐 | 持续调用时表现不稳 |
| NasaCode 优化路由 | 为持续流打造,延迟稳定 | 面向开发者的低延迟节点 | 桌面与命令行都友好 | 隐私优先,不记录流量 | 专为长时间 IDE 与 agent 会话调优 |
几个常被问到的问题
把超时时间直接调大,能解决吗
很少能。更长的窗口只在流确实快传完的时候才有意义。如果路径在丢包、或者连接被反复重置,调大超时不过是让你多等几分钟,再去迎接同一个失败。先把路修好。
换台更快的电脑会不会好点
不会。超时是个网络事件——字节正在你的终端和 API 之间往返飞行。CPU 和内存决定本地工具跑多快,但决定不了响应流能不能熬过一个丢包的跳点。
怎么判断到底是官方故障,还是我自己网络的问题
先看官方状态页。如果它显示一切健康,而你这边连最简单的提示都失败或卡死,那故障就在你的线路上。换个网络复测,一分钟之内就能下结论。
长时间的 agent 任务,怎么才能不超时
把每一步的负载控制在合理范围是一方面,但更要紧的是跑在一条延迟稳定、丢包低的路由上。只有连接够稳,多步 agent 任务才能从头到尾把流保持住。
说到底
Claude Code 连接超时,几乎总是一个披着应用层外衣的路径问题。别再靠猜——去测延迟、测丢包,解法自然就清楚了:把路径稳住。NasaCode 做的就是这件事,低延迟节点专门针对 AI 编程工具那种持续流式流量调优,让会话在最长的一次重构里也能挺住。
如果你正被这种半路中断折磨,不妨去 NasaCode 把 Claude Code 接到一条优化路由上试试,看看心流还会不会被打断。