网络慢不要凭感觉猜,先把一次请求拆成几段
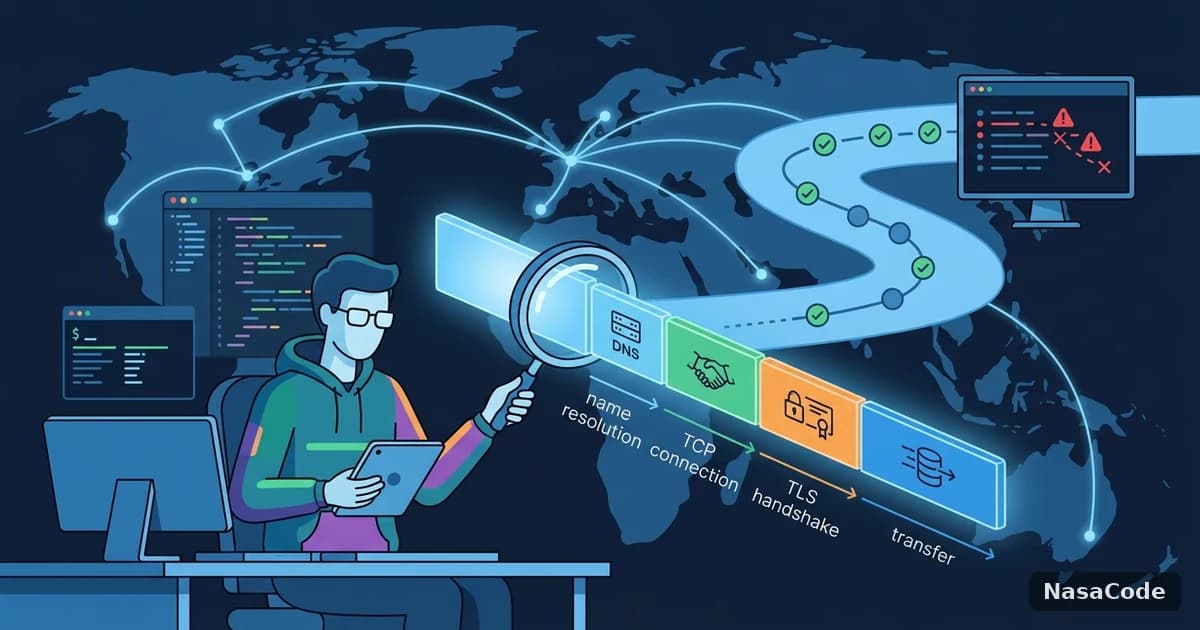
「今天网有点卡」这种描述对排障几乎没有帮助。一次 HTTPS 请求至少要经历域名解析、建立 TCP 连接、TLS 握手、发送请求、等待服务端第一个字节、接收内容这几步,每一步的原因和处理方式都不同。开发者手边有三件现成的工具可以把这几段拆开:curl -w 拆解单次请求的耗时,mtr 和 traceroute 看路径与丢包。本文把这三件工具怎么用、输出怎么读、最容易误读的地方在哪里说清楚。curl 的计时变量对照官方手册整理,文中的数字输出都是为了展示格式的示意值,不代表任何真实线路的测量结果。

curl -w:把一次请求拆成四段
curl 的计时变量都是累计值
按官方手册,time_namelookup、time_connect、time_appconnect、time_pretransfer、time_starttransfer、time_total 都是从请求开始算起的累计时间。也就是说,每一段的真实耗时要用相邻两个值相减得到:解析耗时等于 time_namelookup,TCP 连接耗时等于 time_connect 减 time_namelookup,TLS 握手等于 time_appconnect 减 time_connect,服务端等待等于 time_starttransfer 减 time_pretransfer。直接把累计值当成单段耗时,是最常见的误读。
curl -sS -o /dev/null https://example.com -w \
"dns=%{time_namelookup} tcp=%{time_connect} tls=%{time_appconnect} pre=%{time_pretransfer} ttfb=%{time_starttransfer} total=%{time_total} ip=%{remote_ip}\n"
把域名换成你要检查的服务地址。下面是一个格式示意,数字仅用来说明怎么相减:若输出 dns=0.020 tcp=0.180 tls=0.400 ttfb=0.900,则 TCP 连接约 0.16 秒,TLS 握手约 0.22 秒,服务端等待约 0.5 秒。
四段里哪一段大,分别说明什么
| 偏大的这一段 | 更可能说明 | 下一步动作 |
|---|---|---|
| 域名解析(dns) | 解析服务慢或配置错位 | 检查系统 DNS,参考 DNS 排查文章 |
| TCP 连接(tcp 减 dns) | 链路延迟高或丢包重传 | 用 mtr 查路径和丢包 |
| TLS 握手(tls 减 tcp) | 握手往返多、中间设备干预或证书链较长 | 检查代理、TLS 检查设备 |
| 等待首字节(ttfb 减 pre) | 服务端处理慢、排队 | 换时段复测,确认是不是服务端的问题 |
两点建议:第一,单次测量没有意义,至少在同一网络下连测 10 次再看中位数和最大值;第二,把 remote_ip 也记录下来,确认每次连到的是同一个地址,否则不同时间的结果不能直接对比。解析层面的不一致可以对照DNS 解析异常与出口 IP 的排查。
mtr:看路径,也看丢包
mtr 把 ping 和 traceroute 合在一起,持续对路径上每一跳发探测,统计丢包率和延迟。报告模式适合保存和发给别人:
mtr -rwbz -c 100 example.com
# 若服务端不回应 ICMP,换 TCP 探测
mtr -rwbz -c 100 -T -P 443 example.com
参数含义分别是报告模式、宽输出、同时显示主机名与 IP、显示 AS 号、探测 100 次,-T -P 443 表示改用 TCP 目的端口 443 探测。不同平台的 mtr 版本参数略有差异,用 man mtr 核对。报告里的列分别是:Loss% 丢包百分比、Snt 发送次数、Last 最近一次延迟、Avg 平均延迟、Best 最低延迟、Wrst 最高延迟、StDev 抖动程度。
中间某一跳显示丢包,是不是真的有故障
不一定。路由器往往把回应探测包的优先级放得很低,却会正常转发真实流量,所以中间某一跳显示有丢包,而后面的跳和终点都是 0%,通常只是该路由器对 ICMP 请求限速,并不影响你的真实流量。真正需要关注的丢包特征是:从某一跳开始,之后所有跳包括终点都有类似的丢包。
Wrst 很大但 Avg 正常,该怎么理解
最高延迟只是单次探测的极值,一个异常值就能让它看起来很差。更稳妥的判断是把 StDev 和多轮测试的分布一起看:如果平均延迟正常但报告里抗拖大的抖动反复出现,说明链路有不稳定的拥塞或丢包重传,和某个长连接、流媒体类请求的卡顿相关。
traceroute:适合看路径的一次性快照
traceroute 通过逐步增加生存时间(TTL)让每一跳路由器回应,列出路径上的路由器。它适合看路径绕了多大的弯、哪一跳开始延迟明显跳升,但它只是一次性快照,不适合判断丢包。默认探测方式因系统而异,有些系统默认用 UDP,可以改用 ICMP 或 TCP 探测再对比,因为不同协议的探测包可能被中间设备区别对待,结果不一定一致。
- 先用
curl -w确定慢在 TCP、TLS 还是服务端等待。 - 如果是 TCP 段偏大,再用
mtr跑一轮 100 次报告,只关注终点和起始丢包的那一跳。 - 需要看路径绕行时才用
traceroute,换一种探测协议再跑一次对比。 - 把同一组命令在不同时段、不同网络(例如手机热点)各跑一次,再判断是线路的问题还是服务端的问题。
这几个工具的局限也要清楚:路由可能是不对称的,去程和回程走不同的路径,在本地只能看到去程;若服务器不回应 ICMP,终点显示 100% 丢包并不代表服务不可用。遇到「大文件卡死、小请求正常」这类现象,还要考虑 MTU 和分片,见VPN 为什么会导致大文件传输卡死。
把这套方法写进排查编排
记录格式比工具本身更重要。建议建一个简单的表格,每次记录时间、所在网络、目标、remote_ip、四段耗时和 mtr 的终点丢包率,分别在工作时段、晚高峰、凌晨各记录几次。一周之后你就会有一份自己的基线,之后再遇到「变慢了」,直接拿现在的数据比对,而不是凭记忆。这也是与线路服务商沟通时最有说服力的证据。
排查之后如果确认瓶颈在你的出口线路而不是服务端,就值得考虑换一条更适合开发流量的出口。NasaCode 提供面向开发场景的直连优化和分流规则,可以拿上面这套记录表作为前后对照,用自己的数据判断有没有改善,而不是只看宣传数字。延迟到底卡在哪一段,也可以和VPN 会拖慢网速吗的延迟拆解一起看。
小结
用 curl -w 把请求拆成 DNS、TCP、TLS、首字节四段,用 mtr 看路径和丢包的持续表现,用 traceroute 看一次性的路径快照,再把结果按时段记录成自己的基线。记住两个误读:累计值不能当单段耗时,中间跳的丢包不一定是故障。命令参数在不同系统上有差异,请以本机手册为准。